LLM auto-hébergés en entreprise : l’essor de l’IA souveraine
Pourquoi les entreprises vont transférer les données clients vers des LLM auto-hébergés : CLOUD Act, risques d’accès, modèles ouverts et architecture hybride.

Long Nguyen
Développeur fullstack · Ingénieur IA · Chercheur
Ma position en un paragraphe
Les modèles d’IA les plus performants au monde sont aujourd’hui développés par une poignée d’entreprises américaines et exécutés sur leurs infrastructures. Pour une entreprise située hors des États-Unis, cela crée deux risques qui n’ont rien à voir avec la qualité des modèles : les données envoyées peuvent être accessibles dans le cadre d’une procédure judiciaire américaine, et l’accès lui-même peut être modifié ou suspendu par la politique des États-Unis. Je parie que, dans les prochaines années, les entreprises qui traitent des données clients sensibles transféreront cette partie de leurs usages de l’IA vers des modèles open-weight qu’elles feront fonctionner elles-mêmes. Les API de pointe ne disparaîtront pas. Elles cesseront simplement d’être l’endroit où sont envoyées les données clients.
Il s’agit d’une prévision, pas d’une certitude. La suite de cet article explique pourquoi je défends cette idée, dans quels domaines elle est moins solide qu’il n’y paraît et ce que l’auto-hébergement implique réellement.
Qui contrôle l’IA utilisée par votre entreprise ?
Le , des dirigeants de Google, OpenAI, Anthropic, Meta, xAI et Nvidia ont rencontré le président Trump à la Maison-Blanche et signé un accord visant à encadrer eux-mêmes le développement de l’IA : surveillance interne, équipes internes chargées de vérifier l’efficacité des garde-fous et auditeurs externes. Cet accord est volontaire et non contraignant, et ne dit rien de la manière dont les données clients sont traitées.
Quelle que soit votre opinion sur l’autorégulation, regardez qui était présent. Les règles qui façonnent les modèles utilisés par la plupart des entreprises sont négociées entre des sociétés américaines et le gouvernement américain. Une clinique en Allemagne, un distributeur en Australie ou une entreprise de logistique au Vietnam qui utilise ces modèles n’a pas voix au chapitre. Les conditions d’utilisation de votre fournisseur, les lois de son pays et les priorités de son gouvernement s’interposent entre vous et votre propre infrastructure d’IA.
Ce n’est pas une théorie du complot. C’est le fonctionnement de la compétence juridique, et c’est la même raison pour laquelle de nombreuses entreprises conservent déjà leurs bases de données stratégiques sur des infrastructures qu’elles contrôlent.
Le gouvernement américain peut-il accéder aux données envoyées à une API d’IA ?
Dans certaines conditions juridiques précises, oui, et l’emplacement du serveur n’y change rien. Le CLOUD Act, adopté en 2018, a confirmé que les fournisseurs américains doivent communiquer les données en leur possession, sous leur garde ou sous leur contrôle en réponse à une procédure judiciaire américaine valide, même si ces données sont stockées à l’étranger. Le ministère américain de la Justice présente cette loi ainsi que les accords de partage de données qui en découlent dans ses ressources sur le CLOUD Act. Par ailleurs, la section 702 de la FISA permet aux agences de renseignement américaines de contraindre des fournisseurs américains à contribuer au ciblage de personnes non américaines situées hors du pays.
Il est facile d’exagérer ce risque. Voici donc ce que cela signifie, et ce que cela ne signifie pas :
| Affirmation | Exact ? | Version précise |
|---|---|---|
| « Choisir une région de données dans l’UE ou en Asie protège mes données du droit américain » | Non | Si le fournisseur est une entreprise américaine, les données sous son contrôle peuvent être accessibles où qu’elles soient stockées |
| « Le gouvernement américain lit tout ce qui est envoyé à ChatGPT, Gemini ou Claude » | Non | L’accès nécessite une procédure juridique et vise des données précises ; il ne s’agit pas d’une lecture systématique de tout le contenu |
| « Les paramètres de conservation nulle des données suppriment le risque » | En partie | Les données qui ne sont pas conservées ne peuvent pas être communiquées ultérieurement, mais elles transitent tout de même par les systèmes du fournisseur |
| « Pour une entreprise soumise à une réglementation, c’est une vraie question de conformité » | Oui | Les autorités de protection des données, les clients professionnels et les accords de confidentialité demandent de plus en plus précisément où les données clients sont traitées et qui peut contraindre leur accès |
Pour la plupart des petites et moyennes entreprises, la pression concrète ne viendra pas d’une demande gouvernementale. Elle viendra d’un questionnaire de sécurité client demandant où vont les données lorsque votre IA les traite, et d’une réponse comme « une API américaine » qui vous fera perdre le contrat.
L’accès à l’IA peut être coupé, pas seulement surveillé
La question des données reçoit le plus d’attention, mais l’événement qui a changé ma manière de voir les choses cette année concernait la disponibilité. Le , Anthropic a suspendu l’accès à deux de ses modèles phares pour tous ses clients dans le monde entier, à la suite d’une directive du gouvernement américain invoquant la sécurité nationale, comme l’explique la déclaration d’Anthropic sur la suspension de l’accès aux modèles. L’accès a été rétabli le , après la levée des contrôles à l’exportation concernés par le Department of Commerce.
Trois semaines sont supportables pour un assistant conversationnel. Elles ne le sont pas si le modèle est intégré à votre traitement des commandes, à votre service client ou à un produit que vous commercialisez. Aucun contrat avec le fournisseur n’aurait pu empêcher cela, puisque le fournisseur lui-même n’avait pas le choix.
Les modèles open-weight fonctionnent différemment. Une fois les poids d’un modèle installés sur votre propre serveur, ils ne peuvent pas être récupérés, limités, soumis à une nouvelle tarification ou désactivés depuis l’extérieur. C’est cette propriété, davantage que l’intelligence brute, pour laquelle je m’attends à voir les entreprises commencer à payer.
Pourquoi les LLM auto-hébergés progressent maintenant
L’auto-hébergement n’est pas nouveau. Ce qui l’est, c’est qu’il est devenu suffisamment performant et abordable pour les tâches courantes des entreprises. Quatre éléments ont changé :
- La qualité des modèles open-weight a rattrapé son retard pour les tâches courantes. L’extraction, la classification, la synthèse, la rédaction de réponses du support et les questions-réponses sur des documents internes ne nécessitent plus un modèle de pointe. Les modèles open-weight de taille intermédiaire s’en chargent très bien.
- Le choix entre les familles de modèles est réel. Qwen, DeepSeek et Kimi en Chine, Llama de Meta, Gemma de Google, gpt-oss d’OpenAI et Mistral en France publient tous des poids téléchargeables sous des licences autorisant l’usage commercial, avec des différences qu’il faut vérifier.
- Les logiciels d’inférence ont gagné en maturité. Des serveurs d’inférence open source comme vLLM et llama.cpp proposent une API compatible avec OpenAI. Un code écrit pour une API hébergée peut pointer vers votre propre serveur après une simple modification de configuration.
- Les acheteurs ont commencé à poser des questions. Les clauses de localisation des données, les analyses de transfert au titre du RGPD et les questions relatives à l’IA dans les audits de sécurité des fournisseurs sont désormais courantes dans les ventes aux entreprises.
Le détail inconfortable des modèles open-weight
Plusieurs des familles open-weight les plus performantes viennent de laboratoires chinois. Pour la souveraineté des données, cela compte moins qu’on pourrait le croire : les poids exécutés sur votre propre matériel ne renvoient rien à ceux qui les ont entraînés. Cela mérite tout de même une vérification approfondie. Lisez la licence, testez le comportement du modèle sur vos propres tâches et sur des sujets sensibles, et téléchargez les poids uniquement depuis le dépôt officiel de l’éditeur. La souveraineté signifie que vous décidez de ce qui s’exécute. Elle ne signifie pas qu’il faut faire aveuglément confiance à un modèle parce qu’il fonctionne en local.
LLM auto-hébergé ou API : comparaison honnête
| Critère | API de pointe hébergée | Modèle open-weight auto-hébergé |
|---|---|---|
| Destination des données clients | Infrastructure du fournisseur, soumise à sa juridiction | Vos serveurs ou le fournisseur local de votre choix |
| Exposition aux procédures judiciaires étrangères | Oui, si le fournisseur y est soumis | Uniquement votre propre juridiction |
| Contrôle de la disponibilité | Le fournisseur et son gouvernement décident | Vous décidez ; les poids ne peuvent pas être récupérés |
| Plafond de qualité | Le plus élevé du marché | Inférieur pour les raisonnements complexes ; suffisant pour la plupart des tâches courantes |
| Coût initial | Aucun | Matériel GPU ou serveurs GPU réservés, plus la mise en place |
| Coût à volume élevé et régulier | Augmente linéairement avec le nombre de tokens | Principalement fixe ; moins cher par token une fois le matériel bien utilisé |
| Coût à faible volume | Faible | Élevé : vous payez des GPU inactifs |
| Charge d’exploitation | Presque nulle | Les mises à jour, la supervision, la mise à l’échelle et la sécurité sont à votre charge |
| Délai avant une première version fonctionnelle | Quelques heures | De quelques jours à plusieurs semaines |
Si vous lisez ce tableau honnêtement, la conclusion n’est pas « auto-héberger tout ». Elle est la suivante : auto-hébergez les usages pour lesquels le contrôle des données ou la disponibilité comptent davantage que l’intelligence maximale.
Ce qu’il faut réellement pour exécuter un LLM en interne
Matériel : le calcul de la mémoire
La première question de dimensionnement concerne la mémoire GPU. Les poids seuls nécessitent approximativement le nombre de paramètres multiplié par le nombre d’octets par paramètre : 2 octets en précision 16 bits, 1 octet en 8 bits et environ un demi-octet avec une quantification 4 bits. À cela s’ajoute le cache KV, qui augmente avec la longueur du contexte et le nombre d’utilisateurs simultanés. Prévoyez donc une marge de 20 à 50 %, voire davantage pour les documents longs ou les nombreuses requêtes concurrentes.
| Taille du modèle | Poids en 16 bits | Poids en 4 bits | Configuration typique |
|---|---|---|---|
| ~8B paramètres | ~16 Go | ~4 Go | Un GPU de 24 Go ; adapté à la classification, l’extraction et la rédaction courte |
| ~32B paramètres | ~64 Go | ~16 Go | Un GPU de 24 à 48 Go en version quantifiée ; solide pour le RAG et les agents de support |
| ~70B paramètres | ~140 Go | ~35 Go | Un GPU de 48 à 80 Go en version quantifiée, ou plusieurs GPU |
| Grand modèle mixture-of-experts (centaines de milliards de paramètres) | Des centaines de Go | Toujours très élevé | Serveur multi-GPU ; pertinent uniquement à une échelle réelle |
La plupart des cas d’usage professionnels que je rencontre se situent entre 8B et 32B. Le passage aux plus grands modèles open source est rarement justifié par la tâche. Il l’est généralement par une capture d’écran de benchmark.
La pile logicielle
- Serveur d’inférence exposant un endpoint compatible avec OpenAI (vLLM pour la production multi-utilisateur, llama.cpp pour les configurations plus petites ou fortement orientées CPU).
- Recherche dans vos propres documents : un modèle local d’embeddings ainsi qu’un vector store tel que PostgreSQL avec pgvector, afin que les documents ne quittent pas non plus votre réseau.
- Passerelle pour l’authentification, les quotas par équipe et une journalisation conservée en interne.
- Jeu d’évaluation : des tâches réelles avec des réponses de référence, exécutées à chaque modification du modèle ou du prompt.
Le coût de migration est inférieur à ce que la plupart des équipes imaginent. Servir un modèle open-weight et l’appeler avec le SDK Python standard d’OpenAI ressemble à ceci :
# on your GPU server: serve a model downloaded from its official repository
vllm serve <model-id> --max-model-len 32768 --port 8000

# in your application: same SDK, different base_url
from openai import OpenAI

client = OpenAI(base_url="http://10.0.0.5:8000/v1", api_key="internal")

reply = client.chat.completions.create(
    model="<model-id>",
    messages=[{"role": "user", "content": "Summarize this customer ticket: ..."}],
)
print(reply.choices[0].message.content)
Modifier l’URL de base est la partie facile. Le véritable travail se trouve derrière : vérifier qu’un modèle plus petit appelle vos outils de manière fiable, respecte votre format de sortie sous contrainte et n’invente pas de réponses lorsque la recherche ne renvoie aucun résultat. L’agent de netalith.com fonctionne avec une API hébergée, et c’est un choix délibéré : il répond à partir de nos pages publiques. Un agent qui lit le CRM, les contrats ou les dossiers médicaux d’un client relève d’un tout autre calcul, et c’est là que je construirais une solution basée sur un modèle auto-hébergé. Si vous envisagez cette transition pour vos propres données clients, c’est précisément le type de travail couvert par notre service de développement d’IA pour chatbots et agents de données, de la sélection et de l’évaluation du modèle jusqu’au déploiement sur une infrastructure que vous contrôlez.
L’aboutissement réaliste : une architecture LLM hybride
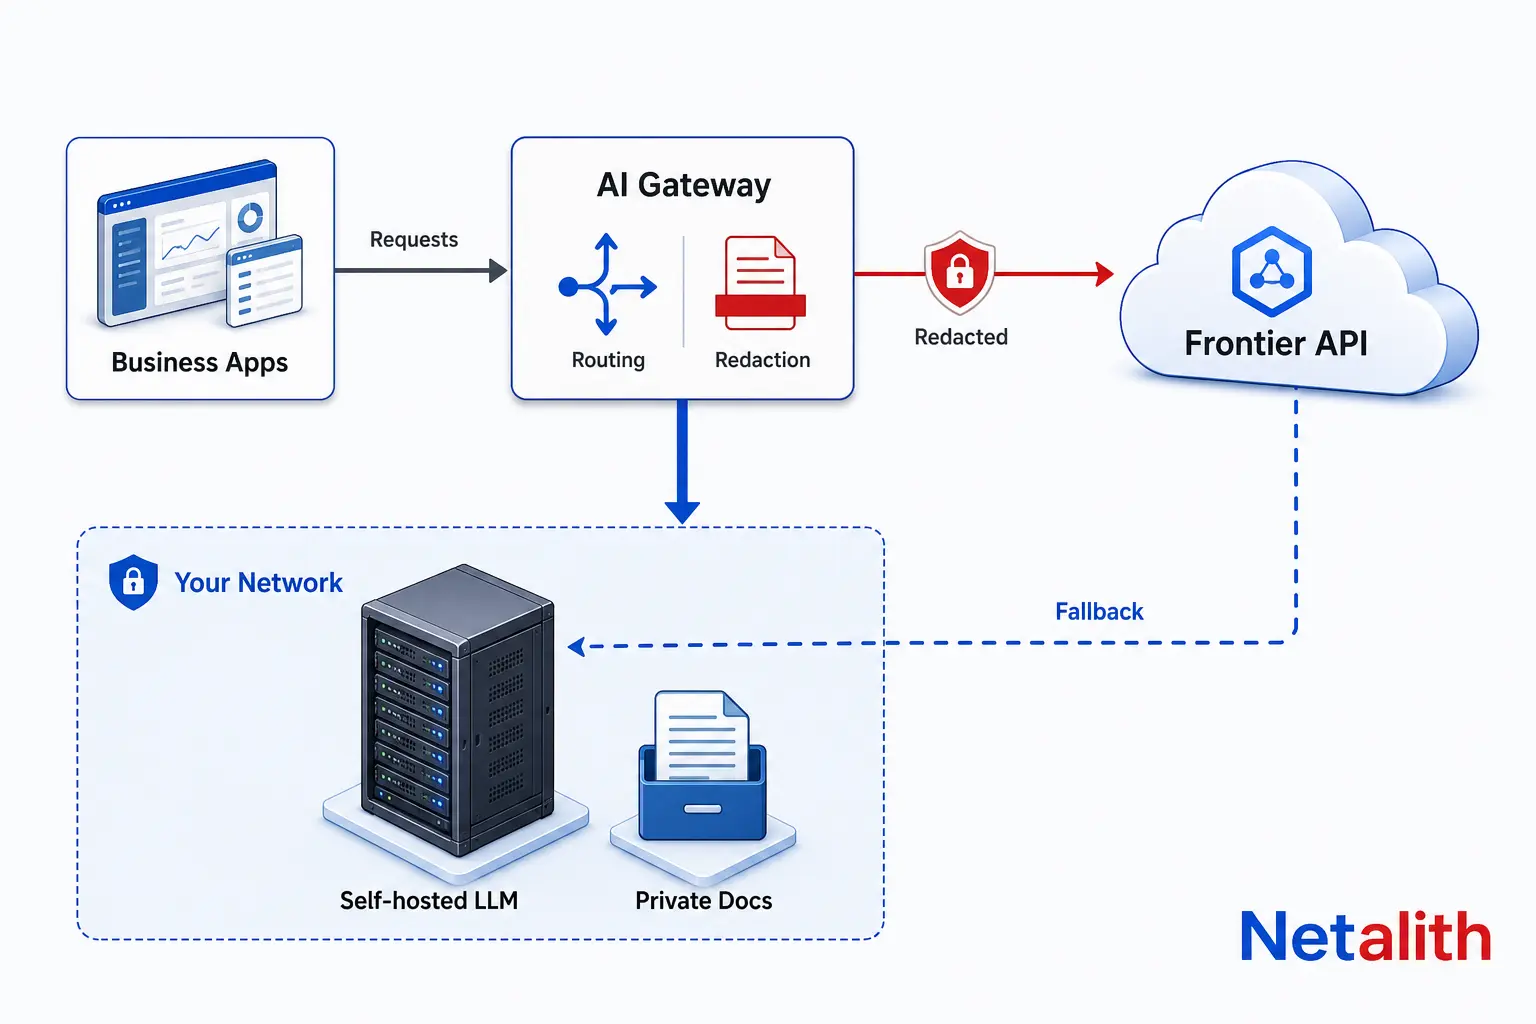
Je ne m’attends pas à ce que les entreprises abandonnent les API de pointe. Je m’attends à ce qu’elles mettent en place un routage. Les données sensibles restent sur un modèle qu’elles exécutent elles-mêmes. Les raisonnements complexes sur des contenus non sensibles sont envoyés à l’API la plus performante disponible. Une couche de routage prend la décision et supprime les données personnelles avant toute sortie du réseau.
| Charge de travail | Lieu d’exécution | Pourquoi |
|---|---|---|
| Réponses du support utilisant l’historique client | Auto-hébergé | Données personnelles, volume élevé, raisonnement courant |
| Questions-réponses sur des contrats, dossiers RH et documents financiers | Auto-hébergé avec recherche locale | Les documents confidentiels ne quittent jamais le réseau |
| Classification et extraction de champs dans des commandes ou des factures | Auto-hébergé, avec un petit modèle | Abordable, rapide et facile à évaluer |
| Textes marketing, recherche publique et code sur des projets open source | API de pointe | Aucune donnée sensible ; la qualité maximale est utile |
| Analyse complexe nécessitant des données clients | API de pointe après anonymisation, ou grand modèle auto-hébergé | Dépend du niveau de sensibilité des données et de la complexité de la tâche |
Cette même conception résout le problème de disponibilité. Si un fournisseur externe disparaît pendant trois semaines, la couche de routage bascule sur le modèle local. La qualité diminue pour certaines tâches, mais l’entreprise continue de fonctionner.
Quand l’auto-hébergement d’un LLM est une mauvaise décision
Il est plus important d’être honnête sur les limites que de remporter le débat. N’auto-hébergez pas si :
- Votre volume est faible. Un GPU qui reste inutilisé la majeure partie de la journée coûte plus cher que des années d’appels API.
- Personne ne sait l’exploiter. Un serveur d’inférence non corrigé et exposé à Internet représente un risque de fuite de données plus important qu’une API réputée avec conservation nulle des données.
- La tâche nécessite réellement un raisonnement de pointe et les données ne sont pas sensibles. Payez le meilleur modèle et passez à autre chose.
- Vous n’avez aucun jeu d’évaluation. Sans lui, vous ne pouvez pas savoir si le modèle local est suffisamment performant, et vous l’apprendrez par vos clients.
L’auto-hébergement est un compromis : davantage de contrôle et moins de dépendance, en échange de matériel, d’exploitation et d’une certaine perte de qualité sur les tâches les plus difficiles. Mon argument est que, pour les données clients, ce compromis devient intéressant pour beaucoup plus d’entreprises qu’il ne l’était il y a deux ans, et que les entreprises qui s’y préparent maintenant dépenseront moins lorsqu’elles franchiront le pas.
Vous souhaitez déterminer honnêtement quels usages de votre IA devraient être exécutés en interne et lesquels peuvent rester sur une API ? Demandez un devis gratuit en décrivant brièvement vos données et votre volume. Cela ne coûte rien de poser la question, et la réponse pourrait bien être que vous n’avez pas encore besoin d’auto-héberger votre IA.
FAQ
Questions fréquentes
Qu’est-ce qu’un LLM auto-hébergé ?
Un LLM auto-hébergé est un modèle de langage open-weight exécuté sur des serveurs que vous contrôlez, qu’il s’agisse de votre propre matériel ou de serveurs GPU loués, au lieu d’être appelé via l’API d’un fournisseur. Les prompts, les documents et les résultats restent dans votre infrastructure.
Le gouvernement américain peut-il accéder aux données que j’envoie à ChatGPT, Gemini ou Claude ?
En vertu du CLOUD Act, les fournisseurs américains doivent communiquer les données en leur possession, sous leur garde ou sous leur contrôle en réponse à une procédure judiciaire américaine valide, même si elles sont stockées en dehors des États-Unis. Cela nécessite une procédure juridique visant des données précises : cela ne signifie pas que le gouvernement lit tout. Les paramètres de conservation nulle réduisent la quantité de données pouvant être produites, mais les données transitent tout de même par le fournisseur.
Un LLM auto-hébergé est-il aussi performant que GPT, Gemini ou Claude ?
Pas pour les tâches de raisonnement les plus complexes. Pour les tâches professionnelles courantes comme l’extraction, la classification, la synthèse, la rédaction de réponses du support et les questions-réponses sur des documents internes, les modèles open-weight de taille intermédiaire sont généralement suffisamment performants. Testez-les sur vos propres tâches avant de prendre une décision.
De quel matériel ai-je besoin pour exécuter un LLM dans mon entreprise ?
Cela dépend de la taille du modèle. Les poids nécessitent approximativement le nombre de paramètres multiplié par le nombre d’octets par paramètre : environ 4 Go pour un modèle 8B en 4 bits, 16 Go pour un modèle 32B et 35 Go pour un modèle 70B, auxquels il faut ajouter une marge de 20 à 50 % pour le cache KV. De nombreux cas d’usage professionnels tiennent sur un seul GPU de 24 à 48 Go.
Quels modèles open-weight les entreprises peuvent-elles utiliser commercialement ?
Les principales familles open-weight comprennent Qwen, DeepSeek, Kimi, Llama, Gemma, gpt-oss et Mistral. Les licences diffèrent et certaines imposent des conditions d’utilisation. Lisez donc la licence de la version exacte du modèle avant de la déployer.
Dois-je remplacer mon API d’IA par un modèle auto-hébergé ?
Généralement, pas entièrement. Pour la plupart des entreprises, une architecture hybride fonctionne mieux : des modèles auto-hébergés pour tout ce qui touche aux données clients ou confidentielles, des API de pointe pour les tâches non sensibles qui exigent une qualité maximale, et une passerelle qui achemine les requêtes, anonymise les données et bascule vers le modèle local si un fournisseur externe devient indisponible.