Gemini 3.7 Flash : le nouveau modèle de Google expliqué
Découvrez Gemini 3.7 Flash, le modèle de Google pour le code et les agents : contexte d’1 million de tokens, tarifs, benchmarks et accès.

Long Nguyen
Développeur fullstack · Ingénieur IA · Chercheur

Gemini 3.7 Flash est le nouveau modèle d’IA polyvalent de Google DeepMind pour le développement logiciel et les agents, lancé le 13 août 2026. Il s’agit d’une amélioration de Gemini 3.6 Flash, arrivée seulement trois semaines après son prédécesseur, avec des optimisations algorithmiques de sa base de raisonnement plutôt qu’un réentraînement complet. Il conserve la rapidité et le faible coût de la gamme Flash, tout en progressant dans l’ingénierie logicielle, le travail de connaissance axé sur les documents et le développement web. Ce guide explique ce qu’est Gemini 3.7 Flash, les nouveautés, ses benchmarks et ses tarifs, où y accéder et comment il se compare aux alternatives.
Qu’est-ce que Gemini 3.7 Flash ?
Gemini 3.7 Flash est le modèle polyvalent orienté agents de référence de la famille Gemini 3. Il se situe entre les modèles Pro à raisonnement approfondi et la gamme Flash-Lite, conçue pour un débit élevé. Multimodal, il accepte le texte, les images, l’audio et la vidéo, avec une fenêtre de contexte d’un million de tokens et jusqu’à 64K tokens en sortie. Sa date de coupure des connaissances est mars 2026.
Google le présente comme son modèle polyvalent le plus intelligent à ce jour pour le code et les agents, optimisé pour l’orchestration en plusieurs étapes, la refactorisation full-stack et le raisonnement général. Son lancement a aussi mis en évidence un vide notable dans la gamme Google : le plus puissant Gemini 3.5 Pro était toujours retardé au moment de la sortie, ce qui renforce le rôle de la gamme Flash comme modèle de référence au quotidien.
Quelles sont les nouveautés de Gemini 3.7 Flash ?
La principale nouveauté concerne le contrôle de l’effort de raisonnement. Gemini 3.7 Flash permet de régler un niveau de réflexion afin d’arbitrer entre qualité, coût et latence, avec les valeurs LOW, MEDIUM (par défaut) et HIGH. Contrairement à certains modèles précédents, MINIMAL n’est pas disponible et renvoie une erreur de validation de l’API.
- Un meilleur niveau en programmation. Il génère dès le premier essai du code plus facilement déployable et prêt pour la production, et peut finaliser des applications avec moins de prompts.
- Des agents plus rigoureux. Il s’adapte aux blocages, demande des précisions lorsque c’est nécessaire et consacre davantage d’efforts à la planification en plusieurs étapes et aux appels d’outils, ce qui réduit les nouvelles tentatives et la supervision manuelle.
- De meilleures performances sur les documents. Il traite nettement mieux les documents complexes et les workflows professionnels du monde réel que 3.6 Flash.
- Une utilisation améliorée des outils Workspace. Il alimente l’agent Gemini Spark de Google pour rendre le travail de connaissance plus efficace dans les applications Google Workspace.
Benchmarks de Gemini 3.7 Flash
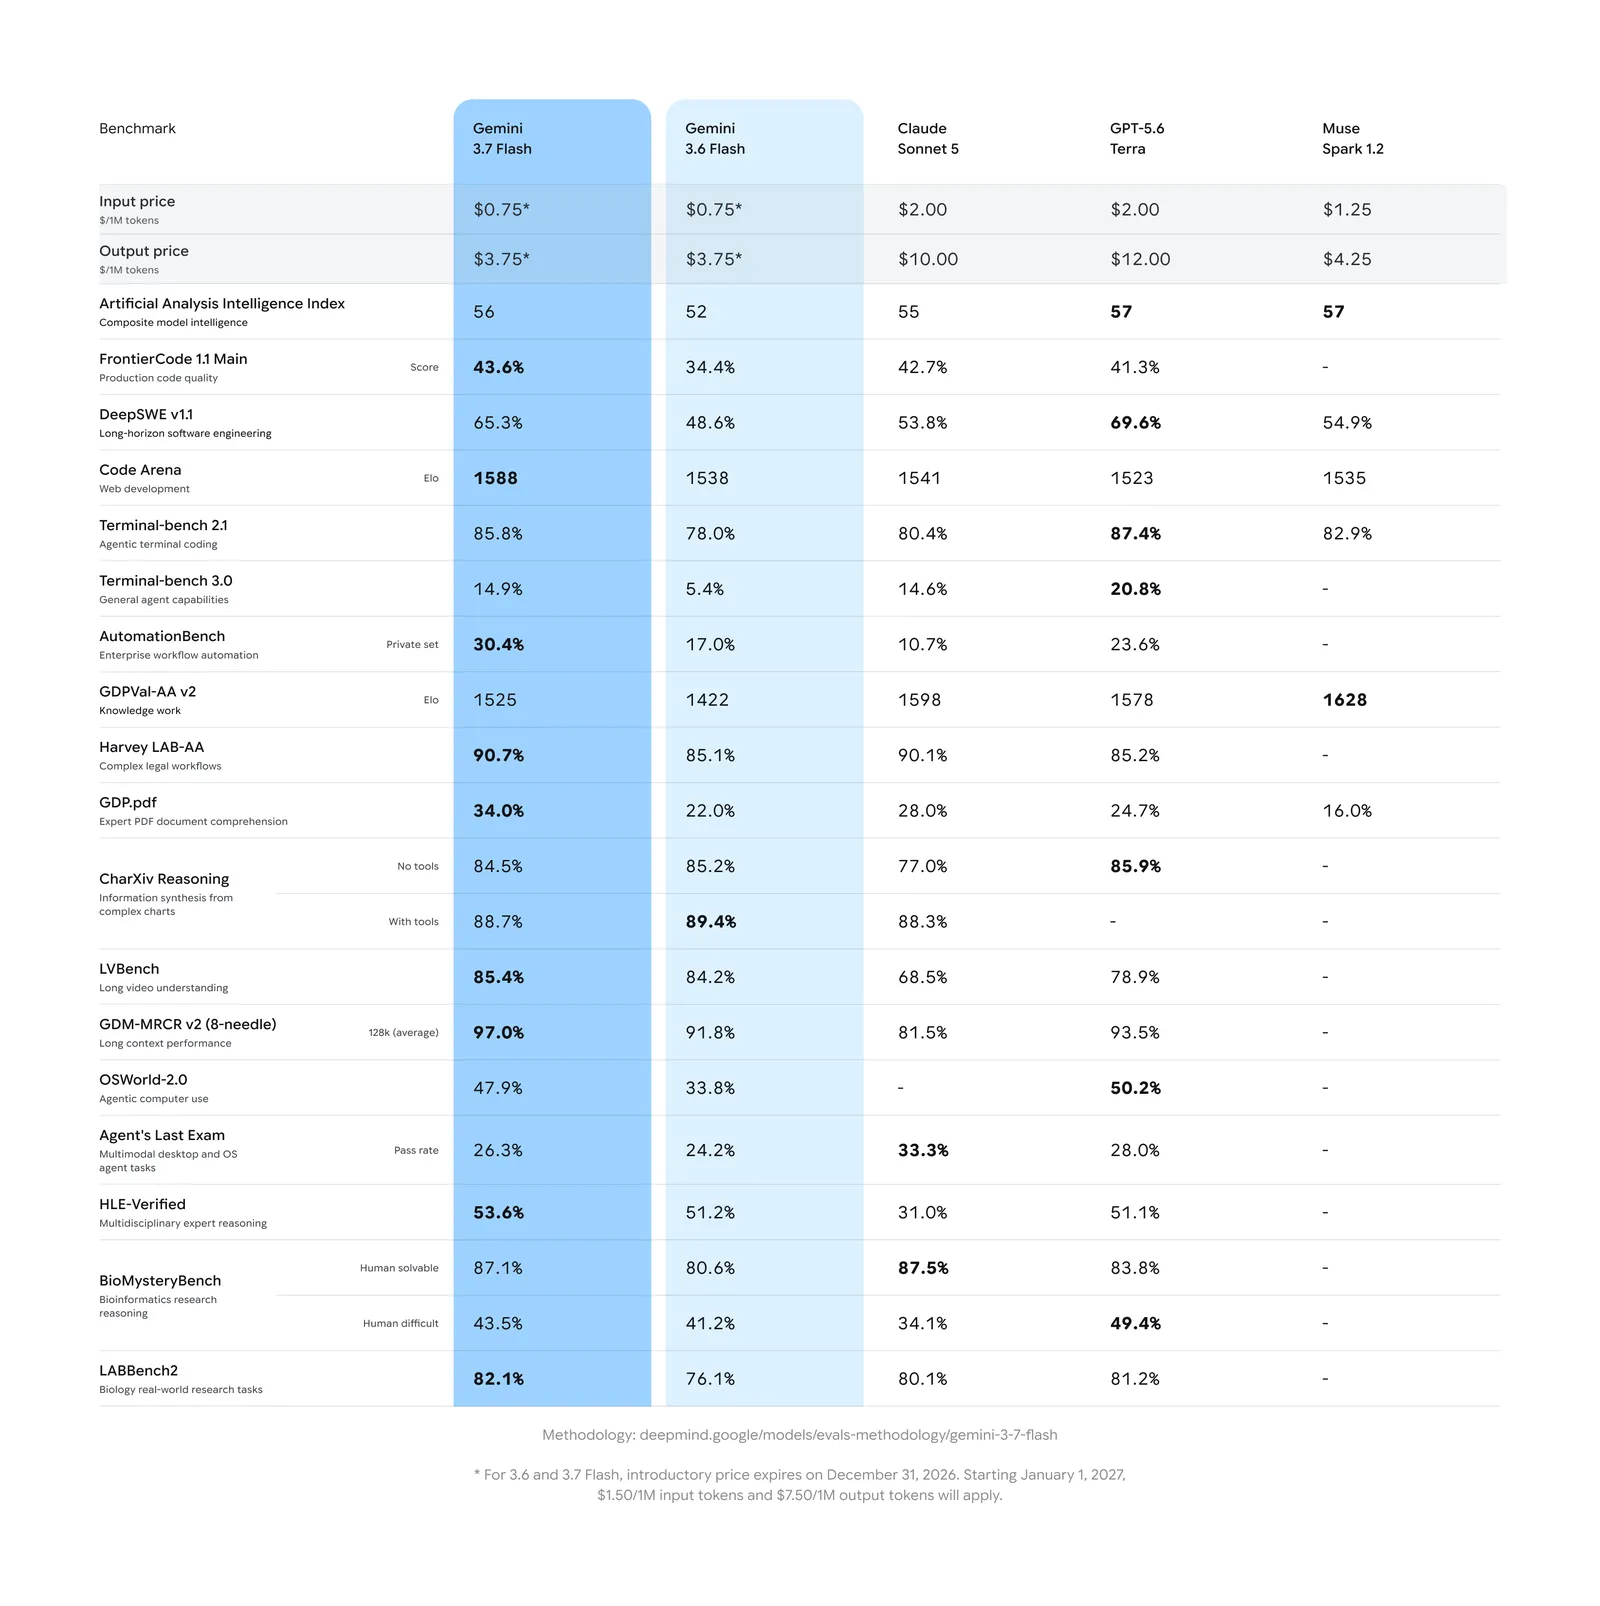
Les progrès par rapport à 3.6 Flash se concentrent sur le code, les agents et le traitement documentaire :
- FrontierCode : 43,6 % contre 34,4 %
- DeepSWE : 65,3 % contre 48,6 %
- WebDev Arena : 1588 Elo
- GDP.pdf (traitement de documents complexes) : 34,0 % contre 22,0 %
- AutomationBench (workflows professionnels du monde réel) : 30,4 % contre 17,0 %
Les progrès sont réels, mais restent progressifs, ce qui correspond davantage à une amélioration d’un modèle existant qu’à une nouvelle base de modèle. Les résultats sont mitigés sur certaines évaluations : le concurrent GPT-5.6 Terra reste devant pour les agents utilisant un terminal et les agents capables d’interagir avec un ordinateur, tandis que CharXiv affiche une légère régression par rapport à 3.6 Flash.
Tarifs de Gemini 3.7 Flash
Le prix est l’atout le plus convaincant. Gemini 3.7 Flash est proposé à 0,75 $ pour 1 M de tokens en entrée et 3,75 $ pour 1 M de tokens en sortie, soit environ la moitié du tarif catalogue initial de 3.6 Flash. Ce tarif de lancement est valable jusqu’au 31 décembre 2026 ; il passera ensuite à 1,50 $ en entrée et 7,50 $ en sortie.
À titre de comparaison, selon les propres comparatifs de Google, Claude Sonnet 5 coûte 2,00 $ / 10,00 $ et GPT-5.6 Terra 2,00 $ / 12,00 $ pour 1 M de tokens. Avec une répartition classique de 80 % de tokens en entrée et 20 % en sortie, Gemini 3.7 Flash revient ainsi à environ 1,35 $ pour 1 M de tokens aujourd’hui, bien moins cher que ses deux concurrents. Pour les équipes qui exécutent des agents à grande échelle, cet écart d’intelligence par dollar est la principale raison de l’évaluer, davantage qu’une victoire sur un benchmark particulier.
Comment accéder à Gemini 3.7 Flash et l’utiliser ?
Le modèle est largement disponible sur les interfaces de développement et d’entreprise de Google, notamment dans l’application Gemini (déploiement progressif via Spark, qui nécessite un abonnement AI Pro ou Ultra), Google Antigravity, AI Studio, Android Studio, la Gemini Enterprise Agent Platform et l’application Gemini Enterprise.
Pour l’API, utilisez l’identifiant de modèle suivant :
gemini-3.7-flashSi vous migrez depuis une configuration plus ancienne, gardez à l’esprit quelques exigences de Gemini 3.x : supprimez temperature, top_p et top_k des configurations de génération, remplacez thinking_budget par l’énumération de chaînes thinking_level et retirez candidate_count, qui n’est pas pris en charge dans Gemini 3.x. Les tours de modèle préremplis doivent également être supprimés. Vérifiez toujours ces informations dans la documentation officielle de Google, car le comportement de l’API peut évoluer.
Gemini 3.7 Flash face à 3.6 Flash et aux concurrents
Face à 3.6 Flash, la version 3.7 est une évolution moins chère et plus performante : des progrès nets en programmation et en traitement documentaire, des agents plus rigoureux et un prix environ deux fois inférieur, le tout livré seulement trois semaines plus tard. Un partenaire a indiqué que l’agent 3.7 Flash lui avait coûté environ 35 % de moins que 3.6 Flash, avec un meilleur taux d’utilisation du cache de prompts et moins d’erreurs lors des appels d’outils.
Face à la concurrence, l’avantage est plus évident sur le prix que sur les capacités de pointe. Gemini 3.7 Flash est nettement moins cher que Claude Sonnet 5 et GPT-5.6 Terra par token, mais GPT-5.6 Terra conserve une longueur d’avance pour les tâches d’agents utilisant un terminal ou un ordinateur. Le bon choix dépend de la sensibilité de votre workload au coût à grande échelle et de votre besoin des capacités spécifiques sur lesquelles les concurrents excellent.
Faut-il passer à Gemini 3.7 Flash ?
Gemini 3.7 Flash constitue un excellent choix par défaut pour les équipes qui développent des assistants de programmation, des pipelines de traitement documentaire et des agents utilisant des outils, lorsque le coût par token est déterminant. Le niveau de réflexion réglable permet de réduire la latence pour les tâches en temps réel ou d’augmenter la qualité pour les raisonnements plus complexes, tandis que le tarif de lancement réduit fortement le coût d’exécution des agents à grande échelle.
Deux réserves doivent être anticipées. Premièrement, le tarif de lancement doublera à partir du 1er janvier de l’année suivante : si vous vous engagez sur le long terme, construisez votre modèle de coûts à partir du tarif applicable après cette période. Deuxièmement, il s’agit d’une amélioration plutôt que d’un bond en avant, et les concurrents restent meilleurs sur certaines tâches d’agents. Testez donc le modèle sur votre propre workload avant de basculer des systèmes de production. Pour les pipelines d’agents déterministes et pilotés par workflow, l’amélioration du respect des instructions et la réduction des erreurs d’outils sont les gains les plus utiles en pratique.
FAQ
Questions fréquentes
Quand Gemini 3.7 Flash est-il sorti ?
Google DeepMind a lancé Gemini 3.7 Flash le 13 août 2026, seulement trois semaines après Gemini 3.6 Flash. Cette sortie s’inscrit dans le rythme accéléré de lancement de la famille de modèles Gemini 3.
Combien coûte Gemini 3.7 Flash ?
À son lancement, il est proposé à 0,75 $ pour 1 M de tokens en entrée et 3,75 $ pour 1 M de tokens en sortie. Ce tarif de lancement est valable jusqu’au 31 décembre 2026, puis passera à 1,50 $ en entrée et 7,50 $ en sortie. Il reste moins cher que des concurrents comme Claude Sonnet 5 et GPT-5.6 Terra.
Quelle est la taille de la fenêtre de contexte de Gemini 3.7 Flash ?
Gemini 3.7 Flash prend en charge une fenêtre de contexte d’un million de tokens et peut générer jusqu’à 64K tokens en sortie. Il est multimodal et accepte le texte, les images, l’audio et la vidéo, avec une date de coupure des connaissances fixée à mars 2026.
Quelle est la différence entre Gemini 3.7 Flash et 3.6 Flash ?
Il s’agit d’une amélioration de 3.6 Flash, avec des optimisations algorithmiques de la base de raisonnement plutôt qu’un nouvel entraînement initial. Le modèle offre de meilleures performances en programmation et en traitement documentaire, des workflows d’agents plus efficaces, une utilisation plus rigoureuse des outils et un prix environ deux fois inférieur, tout en étant sorti seulement trois semaines plus tard.
Où puis-je utiliser Gemini 3.7 Flash ?
Il est disponible dans l’application Gemini via Spark (avec un abonnement AI Pro ou Ultra), ainsi que dans Google Antigravity, AI Studio, Android Studio, la Gemini Enterprise Agent Platform et l’application Gemini Enterprise. Les développeurs peuvent l’appeler via l’API avec l’identifiant de modèle <code>gemini-3.7-flash</code>.
Gemini 3.7 Flash est-il adapté à la création d’agents IA ?
Oui. Il est présenté comme un modèle polyvalent pour les agents, avec une meilleure planification en plusieurs étapes, un meilleur respect des instructions et moins d’erreurs d’outils que 3.6 Flash, ainsi qu’un niveau de réflexion réglable pour équilibrer coût et latence. Notez toutefois que GPT-5.6 Terra reste devant pour les tâches d’agents utilisant un terminal ou un ordinateur : validez donc le modèle sur votre propre workload.