Extraire le texte de CV PDF en Python avec pdfplumber
Extrayez proprement le texte des CV PDF en Python avec pdfplumber et détectez les PDF numérisés avant qu’ils ne perturbent votre application d’entretien IA.

Long Nguyen
Développeur fullstack · Ingénieur IA · Chercheur
Pourquoi l’extraction de texte PDF est plus complexe qu’il n’y paraît
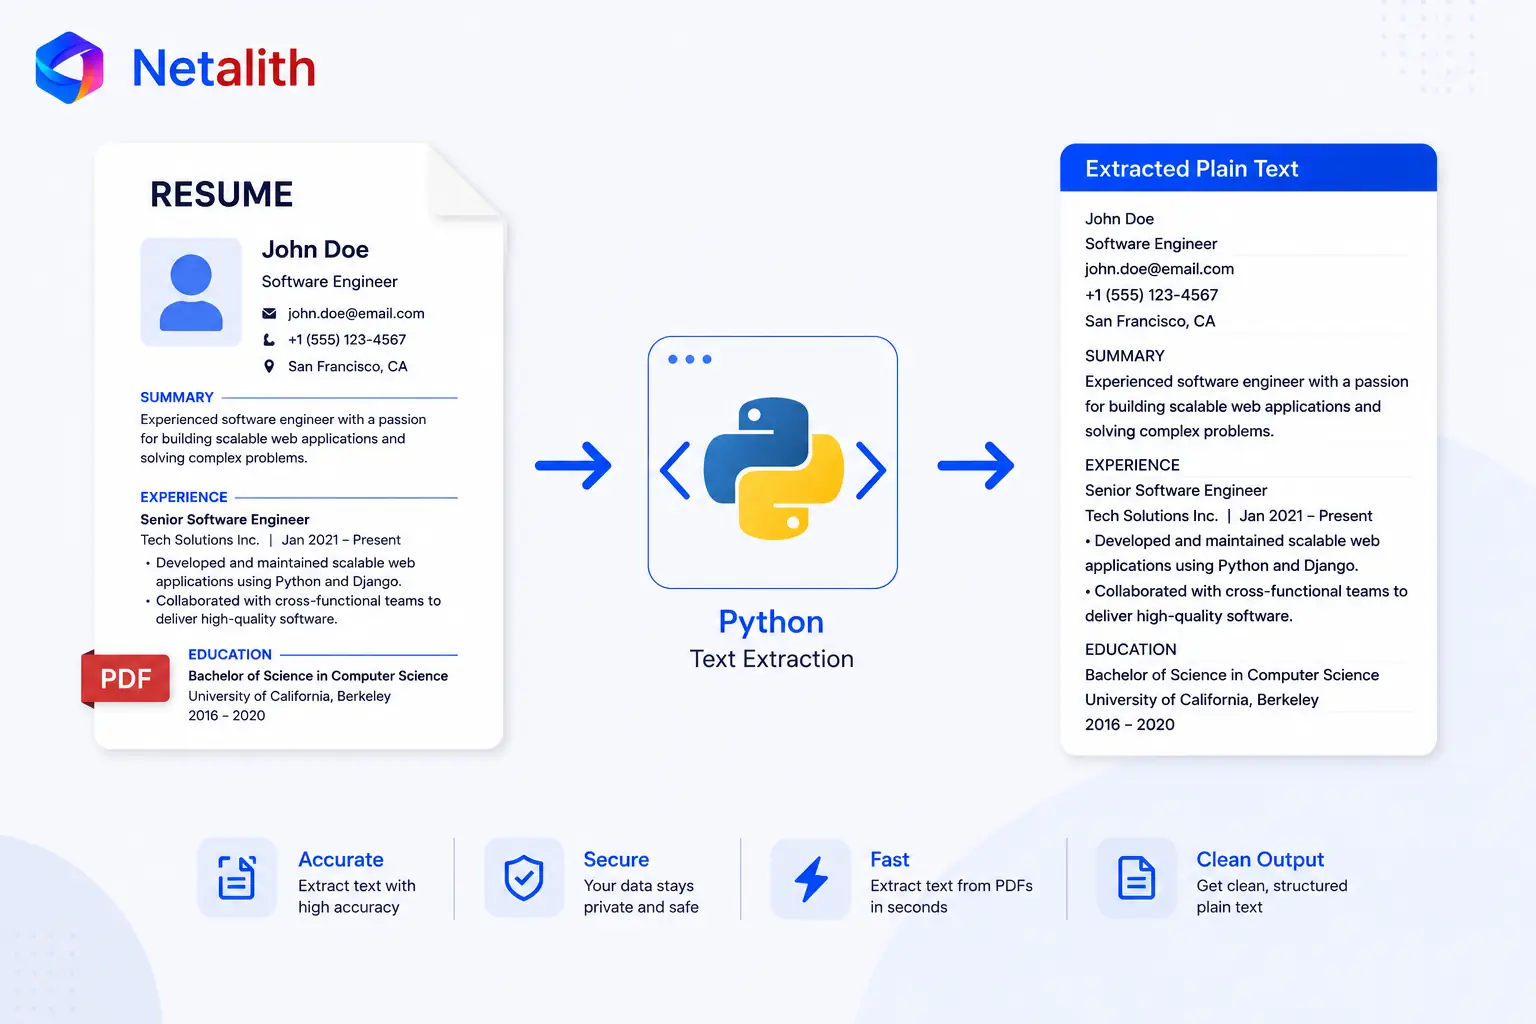
Pour mener l’entretien, l’IA a d’abord besoin du CV du candidat sous forme de texte propre : cette étape explique donc comment extraire le texte d’un CV PDF en Python. Dans la partie 2, nous avons donné à l’application un emplacement pour enregistrer un entretien et son CV. Il est maintenant temps de remplir le champ cv_text.
Le problème, c’est qu’un PDF n’est pas un fichier texte. Il s’agit d’un format de mise en page qui décrit la position des glyphes sur une page, et non un flux de phrases propre. En pratique, le texte extrait peut donc contenir des espaces inhabituels ou des retours à la ligne mal placés, tandis que les CV en plusieurs colonnes peuvent être lus dans le désordre. Pour la plupart des CV réels au format texte, une bonne bibliothèque suffit toutefois à obtenir un résultat assez fiable pour alimenter directement une IA.
Extraire du texte avec pdfplumber
Parmi les bibliothèques PDF Python, pdfplumber offre le meilleur compromis pour les CV : elle préserve bien mieux la mise en page et les espacements que les extracteurs minimalistes, sans nécessiter la configuration lourde d’une véritable solution d’OCR. Commencez par l’installer :
pip install pdfplumberL’extraction elle-même est très courte. Ouvrez le fichier, parcourez ses pages et regroupez le texte en une seule chaîne :
import pdfplumber


def extract_text_from_pdf(file_path):
    with pdfplumber.open(file_path) as pdf:
        return "\n".join(page.extract_text() or "" for page in pdf.pages)
Le or "" est le détail important ici. extract_text() renvoie None pour une page dont le texte ne peut pas être extrait, et regrouper une valeur None provoquerait une erreur. Utiliser une chaîne vide par défaut permet à la fonction de rester fiable avec des fichiers réels et hétérogènes — une petite protection qui vous évite un plantage à cause de l’unique page inhabituelle d’un CV par ailleurs parfaitement exploitable.
C’est tout pour le cas nominal : avec un PDF classique basé sur du texte, vous obtenez en quelques lignes un contenu propre, prêt pour l’IA. Pas besoin d’ajouter trop tôt des abstractions ou une chaîne de nettoyage dont vous n’avez pas encore besoin — il suffit de résoudre directement le problème rencontré. Extraire le texte brut est l’objectif de cette étape ; vérifier qu’il s’agit bien d’un CV est une question distincte, que nous traiterons plus tard au niveau de l’IA. Si vous préférez éviter toute la construction et partir du code complet, prêt pour la production, il est disponible dans un kit de démarrage — sinon, passez à la partie 4, où nous traiterons les CV DOCX, qui dissimulent une grande partie de leur contenu dans des tableaux.
FAQ
Questions fréquentes
Pourquoi choisir pdfplumber plutôt que PyPDF2 ou pypdf ?
pdfplumber préserve mieux la mise en page et les espacements, ce qui est important pour les CV, car leur structure porte une partie du sens. Les bibliothèques plus simples renvoient souvent un texte désordonné, plus difficile à transmettre proprement à une IA.
Comment détecter un PDF numérisé ?
Essayez d’en extraire le texte et mesurez la quantité obtenue. Un véritable PDF texte renvoie un nombre important de caractères ; un PDF numérisé, constitué uniquement d’images, en renvoie très peu, voire aucun. Un seuil de caractères défini pour chaque page constitue un contrôle simple et efficace.
Mon application doit-elle appliquer automatiquement l’OCR aux CV numérisés ?
C’est possible, mais l’OCR ajoute une réelle complexité ainsi que de nouvelles sources d’erreurs. Pour une première version, il est plus simple de détecter le fichier numérisé et de demander un CV basé sur du texte. La version de production traite ce cas de manière plus complète.