Automatiser ses rapports PDF avec l’IA sans erreurs de calcul
Automatisez vos rapports PDF avec l’IA en toute sécurité : le code calcule, le LLM rédige et un modèle génère le PDF. Pipeline Python inclus.

Long Nguyen
Développeur fullstack · Ingénieur IA · Chercheur
Que signifie automatiser des rapports PDF avec l’IA ?
Pour automatiser des rapports PDF avec l’IA, répartissez chaque rapport en trois tâches et confiez chacune à l’outil qui l’exécute de manière fiable : le code calcule les chiffres, un LLM rédige les commentaires et un modèle met en page le document. Les projets qui échouent confient ces trois tâches au modèle.
| Tâche | Responsable | Pourquoi |
|---|---|---|
| Collecter et calculer les données | Code (SQL, pandas) | Déterministe, testable et auditable |
| Rédiger le résumé et les commentaires | LLM, limité par un schéma JSON | Le langage est le domaine dans lequel un modèle est réellement performant |
| Mise en page, graphiques et identité visuelle | Modèle HTML/CSS et moteur de rendu | Une page identique à chaque exécution, modifiable par un designer |
| Vérifier et approuver | Contrôles automatisés, puis validation humaine lors des premières exécutions | Détecte ce que les trois premières tâches ne peuvent pas détecter |
Le reste de ce guide construit ce pipeline en Python autour d’un rapport mensuel des ventes. Remplacez les données par les vôtres : la structure restera la même.
Pourquoi le LLM ne doit produire ni le PDF ni les chiffres
Demander à un modèle de créer un PDF fonctionne dans une démonstration, mais dérive en production. Il existe trois approches courantes, et chacune échoue à un endroit différent.
| Approche | Point de rupture | À utiliser pour |
|---|---|---|
| Le LLM écrit et exécute du code de génération de PDF dans un bac à sable | La mise en page et les chiffres peuvent changer d’une exécution à l’autre, et il est difficile de vérifier ce qui a réellement été calculé | Documents ponctuels |
| Le LLM rédige tout le HTML, puis vous le convertissez en PDF | Le modèle contrôle la structure et le CSS, ce qui fait varier les pages ; son balisage constitue également une entrée non fiable pour votre moteur de rendu | Prototypes |
| Le LLM remplit un schéma JSON, tandis que vous contrôlez le modèle et les chiffres | Davantage de travail initial | Tout document récurrent, destiné à un client ou signé |
La question décisive est de savoir qui est responsable en cas de chiffre erroné. Si la réponse est « vous », le chiffre doit provenir d’un code que vous pouvez tester, et non d’un modèle qui échantillonne du texte. Un rapport récurrent doit également avoir le même aspect en mars qu’en février : seul un modèle fixe peut le garantir.
Le pipeline : le code calcule, le LLM rédige et un modèle génère le PDF
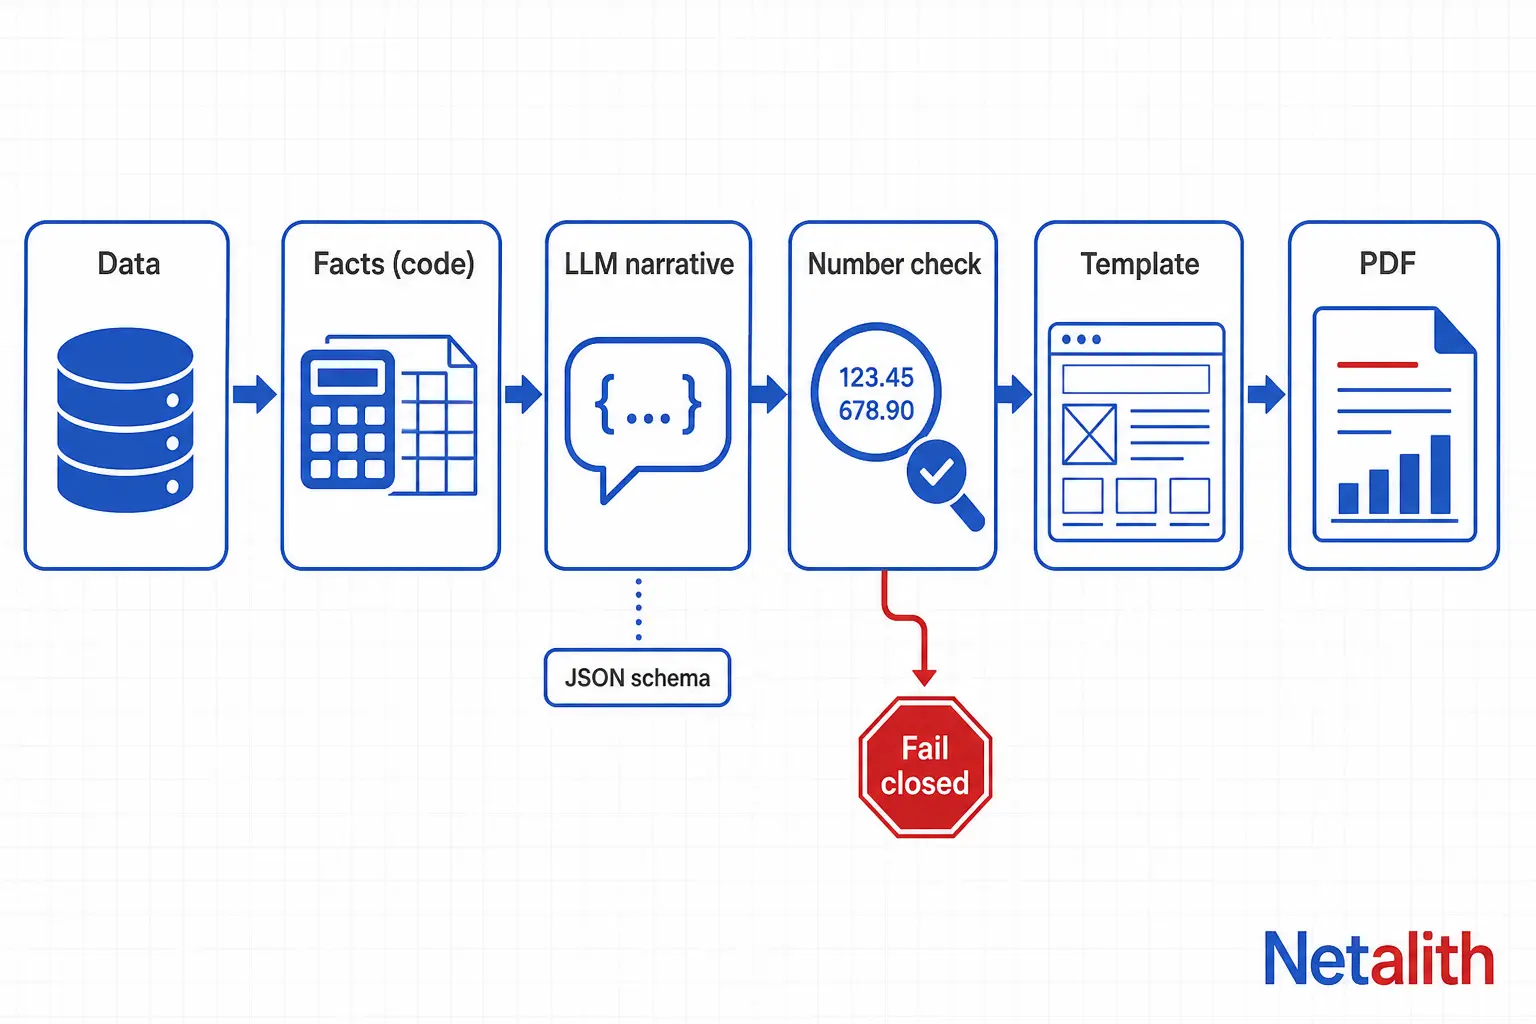
Une architecture fiable comporte six étapes. Une seule fait appel à un modèle.
- Extraire. Récupérez les données brutes depuis une base de données, un fichier CSV ou une API.
- Calculer les faits. Agrégez les données dans le code au sein d’un dictionnaire
facts. Il constitue l’unique source des chiffres du rapport. - Rédiger le texte. Envoyez les faits au LLM et récupérez un JSON conforme à un schéma.
- Vérifier. Confirmez que chaque chiffre du texte existe dans les faits. Bloquez la production si ce n’est pas le cas.
- Générer. Remplissez un modèle HTML et convertissez-le en PDF. Les graphiques sont dessinés par le code, jamais par le modèle.
- Livrer. Stockez le PDF avec ses faits et son texte, puis envoyez-le ou conservez-le en attente d’approbation.
Étape 1 : calculer les faits dans le code
Le dictionnaire de faits constitue le contrat entre vos données et tous les éléments en aval. Construisez-le avec du code classique testé et gardez-le concis : il ne doit contenir que les chiffres que le rapport est autorisé à mentionner.
import pandas as pd

def build_facts(csv_path: str, month: str) -> dict:
    df = pd.read_csv(csv_path, parse_dates=["order_date"])
    period = df["order_date"].dt.to_period("M")
    cur = df[period == pd.Period(month)]
    prev = df[period == pd.Period(month) - 1]

    revenue = round(float(cur["amount"].sum()), 2)
    prev_revenue = round(float(prev["amount"].sum()), 2)
    change_pct = (
        round((revenue - prev_revenue) / prev_revenue * 100, 1)
        if prev_revenue else None      # None, never 0, when there is no baseline
    )
    top = cur.groupby("channel")["amount"].sum().nlargest(3)

    return {
        "month": month,
        "orders": int(len(cur)),
        "revenue": revenue,
        "prev_revenue": prev_revenue,
        "revenue_change_pct": change_pct,
        "top_channels": [
            {"name": name, "revenue": round(float(v), 2)} for name, v in top.items()
        ],
    }
Deux habitudes sont essentielles. Renvoyez None lorsqu’une valeur ne peut pas être calculée : zéro ressemble à un résultat réel et le modèle se fera un plaisir de le commenter. Arrondissez une seule fois, dans cette fonction, afin que le texte et le tableau du PDF ne puissent jamais diverger.
Étape 2 : encadrer le texte avec un schéma JSON
Demandez au modèle de remplir des champs, pas de produire un document. Chaque champ est un emplacement que le modèle positionne ; le modèle ne peut donc rien déplacer, ajouter ou modifier sur la page. Une sortie contrainte par schéma est l’outil adapté : selon la documentation Structured Outputs d’OpenAI, la réponse respecte votre JSON Schema au lieu d’être simplement un JSON valide, et les refus deviennent détectables dans le code. Si vous utilisez un autre fournisseur, recherchez son mode de sortie contraint par schéma : le principe reste identique.
import json
from openai import OpenAI
from pydantic import BaseModel

client = OpenAI()
MODEL = "your-validated-model"   # pin the model you tested; re-test before changing it

class ReportNarrative(BaseModel):
    headline: str
    summary: str
    channel_notes: list[str]
    risks: list[str]

SYSTEM = (
    "You write the commentary for a monthly sales report. "
    "Use ONLY numbers that appear in the facts JSON, copied exactly. "
    "Never calculate, round or estimate. If a value is null, say it is unavailable. "
    "Do not claim trends, causes or records that the facts do not show."
)

def write_narrative(facts: dict) -> ReportNarrative:
    response = client.responses.parse(
        model=MODEL,
        input=[
            {"role": "system", "content": SYSTEM},
            {"role": "user", "content": json.dumps(facts)},
        ],
        text_format=ReportNarrative,
    )
    if response.output_parsed is None:   # refusal or incomplete output
        raise RuntimeError("No valid narrative returned")
    return response.output_parsed
N’oubliez pas ce que le schéma ne garantit pas. Il garantit la structure, pas la véracité : une chaîne parfaitement valide peut tout de même contenir un chiffre inventé par le modèle. C’est la raison d’être de l’étape suivante. Envoyez également des faits agrégés, et non des lignes brutes concernant vos clients. Le modèle n’a besoin que des chiffres qu’il va décrire, et transmettre moins de données est le moyen le plus simple de limiter les risques liés à la confidentialité.
Étape 3 : vérifier chaque chiffre avant l’envoi du PDF
C’est l’étape que la plupart des tutoriels ignorent, alors qu’elle rend le pipeline suffisamment sûr pour fonctionner sans surveillance. Extrayez tous les chiffres du texte généré et exigez que chacun apparaisse dans les faits. Si ce n’est pas le cas, déclenchez une erreur et ne livrez rien.
import re

NUM = re.compile(r"\d[\d,]*\.?\d*")

def to_float(token: str) -> float:
    return float(token.replace(",", "").rstrip("."))

def fact_numbers(obj) -> set[float]:
    nums: set[float] = set()
    if isinstance(obj, dict):
        for v in obj.values():
            nums |= fact_numbers(v)
    elif isinstance(obj, list):
        for v in obj:
            nums |= fact_numbers(v)
    elif isinstance(obj, str):
        nums |= {to_float(m) for m in NUM.findall(obj)}   # catches "2026-09" style periods
    elif isinstance(obj, (int, float)) and not isinstance(obj, bool):
        nums.add(float(obj))
    return nums

def check_narrative(facts: dict, n) -> None:
    allowed = fact_numbers(facts)
    text = " ".join([n.headline, n.summary, *n.channel_notes, *n.risks])
    unknown = [m for m in NUM.findall(text)
               if not any(abs(to_float(m) - a) < 0.01 for a in allowed)]
    if unknown:
        raise ValueError(f"Numbers not found in facts: {unknown}")
Une fois ce contrôle en place, toute l’exécution tient en quatre lignes :
facts = build_facts("orders.csv", "2026-09")
narrative = write_narrative(facts)
check_narrative(facts, narrative)          # raises, so nothing ships
render_pdf(facts, narrative, "reports/sales-2026-09.pdf")
Le contrôle est volontairement strict. Un modèle qui écrit 12 % alors que le fait indique 12,4 est rejeté, tout comme un nombre isolé tel que le 3 de « top 3 channels », sauf si vous ajoutez les petits ordinaux à une liste blanche. Renforcez le prompt avant d’assouplir le contrôle. Les chiffres ne sont pas le seul enjeu : ajoutez au prompt une instruction qui interdit d’affirmer des causes, des tendances ou des records que les faits ne contiennent pas, et lisez vous-même les premiers textes générés.
Durant les premières semaines d’un nouveau rapport, mettez le PDF en attente d’une validation humaine et n’activez l’envoi automatique qu’après une période suffisamment longue de contrôles réussis. Conservez les textes rejetés : ils vous montreront quelle instruction du prompt n’est pas respectée.
Étape 4 : générer le PDF à partir d’un modèle
Rédigez le rapport sous la forme d’un modèle HTML classique et laissez un moteur de rendu le convertir en PDF. WeasyPrint constitue une bonne solution par défaut pour les documents professionnels, car il prend en charge le CSS d’impression. Sa documentation officielle pour la version 70.0 indique que Python 3.10 ou une version ultérieure et Pango 1.44 ou une version ultérieure sont requis. Elle recommande également une installation avec pip, puis l’exécution de weasyprint --info pour vérifier que les bibliothèques système sont détectées.
Le modèle contient la mise en page et les champs du texte viennent s’y insérer :
<h1>{{ n.headline }}</h1>
<p class="lead">{{ n.summary }}</p>
<table>
  {% for c in facts.top_channels %}
  <tr><td>{{ c.name }}</td><td>{{ "{:,.2f}".format(c.revenue) }}</td></tr>
  {% endfor %}
</table>
Le format de page, les marges et les numéros de page se définissent avec du CSS classique :
@page {
  size: A4;
  margin: 18mm;
  @bottom-center { content: "Page " counter(page) " of " counter(pages); }
}
Effectuez ensuite le rendu. L’échappement automatique de Jinja est activé : le texte du modèle est donc inséré comme une donnée et jamais interprété comme du balisage :
from pathlib import Path
from urllib.parse import unquote, urlparse

from jinja2 import Environment, FileSystemLoader, select_autoescape
from weasyprint import HTML
from weasyprint.urls import URLFetcher

TEMPLATES = Path("templates").resolve()
env = Environment(loader=FileSystemLoader(TEMPLATES), autoescape=select_autoescape(["html"]))

class AssetsOnlyFetcher(URLFetcher):
    # Local files are allowed only inside the templates folder
    def fetch(self, url, headers=None):
        if url.startswith("file:"):
            path = Path(unquote(urlparse(url).path)).resolve()
            if not path.is_relative_to(TEMPLATES):
                raise ValueError(f"Blocked local file: {url}")
        return super().fetch(url, headers)

def render_pdf(facts: dict, narrative, out_path: str) -> None:
    page = env.get_template("monthly_report.html").render(facts=facts, n=narrative)
    HTML(string=page, base_url=str(TEMPLATES), url_fetcher=AssetsOnlyFetcher()).write_pdf(out_path)
Trois points de la documentation méritent d’être pris en compte dès la conception :
- Polices. Si une police est absente, le PDF peut afficher des carrés ou aucun caractère à la place des lettres. Le problème apparaît d’abord avec les caractères accentués ou les alphabets non latins. Installez les polices sur le serveur ou référencez-les avec
@font-face. Si vous chargez cette feuille CSS via un objet CSS, transmettez également uneFontConfiguration, comme l’indique la documentation. - Sécurité. La documentation avertit que du HTML ou du CSS non fiable peut lire des fichiers locaux et les intégrer à la sortie. Traitez le contenu du modèle comme une donnée non fiable : ne le laissez jamais générer du HTML brut, gardez l’auto-échapppement activé et limitez l’accès aux fichiers comme dans le fetcher ci-dessus. WeasyPrint intercepte les erreurs du fetcher et les transforme en avertissements : un fichier bloqué est ignoré au lieu de faire échouer l’exécution. Le fetcher sous forme de classe présenté ici correspond à la documentation de la version 70.0 ; les versions plus anciennes utilisaient une fonction simple.
- Vitesse. La documentation indique que le rendu peut être lent pour les documents longs et recommande des processus persistants pour traiter de nombreux documents, afin de ne payer le coût du démarrage qu’une seule fois. Un worker qui reste actif est préférable au lancement d’un nouveau processus pour chaque PDF.
Dessinez les graphiques dans le code avec matplotlib ou SVG et intégrez-les sous forme d’images. Le modèle décrit le graphique ; il ne le dessine jamais.
Quelle bibliothèque Python doit générer le PDF ?
Choisissez le moteur de rendu selon trois critères : la manière dont vous souhaitez décrire la mise en page, votre besoin éventuel de graphiques JavaScript et ce que vous êtes prêt à installer et à utiliser sous licence pour des projets clients. Vérifiez la licence actuelle de la version exacte utilisée avant de la mettre en production pour un client.
| Option | Modèle de mise en page | Graphiques | Poids de l’installation | Licence | À choisir lorsque |
|---|---|---|---|---|---|
| WeasyPrint | HTML et CSS d’impression | Images statiques ou SVG ; pas de JavaScript | Python et bibliothèques système Pango | BSD-3-Clause | Rapports professionnels basés sur un modèle que votre designer peut modifier |
| ReportLab | Code Python | Dessin et graphiques intégrés | Léger, principalement via pip | Édition open source, de type BSD ; des modules commerciaux existent | Mises en page denses et programmatiques à fort volume |
| Headless Chromium via Playwright | Un navigateur complet | Graphiques JavaScript comme Chart.js | Lourd : téléchargement d’un navigateur | Apache-2.0 pour Playwright | Le PDF doit correspondre exactement à un tableau de bord web existant |
Pour la plupart des rapports professionnels récurrents, WeasyPrint associé à un modèle Jinja est le chemin le plus court entre l’idée et un pipeline facile à maintenir. Passez à Chromium uniquement lorsque vous avez réellement besoin de JavaScript pour générer la page.
Comment planifier et distribuer des rapports PDF automatisés
Une fois qu’une exécution fonctionne, le travail restant est essentiellement opérationnel. Voici les décisions qui permettent de conserver un rapport planifié fiable :
- Déclenchement. Utilisez le planificateur que vous exploitez déjà : cron sur un serveur, ordonnanceur cloud, workflow CI planifié ou file de tâches. Le pipeline est une simple fonction Python et n’en dépend pas.
- Idempotence. Identifiez chaque fichier par le type de rapport et la période, afin qu’une nouvelle exécution remplace le fichier au lieu d’en créer un doublon.
- Piste d’audit. Enregistrez ensemble les faits, le texte, la version du modèle et le PDF final. Si quelqu’un remet un chiffre en question, vous pourrez montrer précisément son origine.
- Gestion des erreurs. Si l’étape de vérification échoue, alertez une personne et conservez le dernier PDF valide à disposition. N’envoyez jamais un rapport que vous n’avez pas pu vérifier.
- Distribution. Envoyez un lien par e-mail pour les fichiers volumineux et une pièce jointe pour les petits fichiers, puis consignez le destinataire de chaque version.
L’appel au modèle se limite à une requête par rapport : le coût de fonctionnement le plus important est donc généralement le temps de validation humaine, et non l’utilisation de l’API. Ajustez le niveau de contrôle humain plutôt que la longueur du prompt. Si vous préférez confier cette réalisation à une équipe qui l’adaptera à vos sources de données et à vos modèles, Netalith crée des agents de reporting IA qui produisent des fichiers PDF, DOCX, Excel et PowerPoint.
Quand l’automatisation d’un rapport PDF n’en vaut pas la peine
L’automatisation entraîne un coût fixe : le modèle, le code des faits, les contrôles et la supervision. Elle ne vaut pas la peine dans les cas suivants :
- Le rapport est produit quelques fois par an. Concevoir le modèle prend plus de temps que les heures économisées.
- Chaque destinataire a besoin d’une structure différente et il n’existe aucun socle commun à utiliser comme modèle.
- La valeur du rapport repose sur un jugement professionnel, comme un avis juridique ou une conclusion d’audit. L’IA peut rédiger autour de ce jugement, mais la partie que vous vendez réellement n’est pas celle qui est automatisée.
- Les données sources ne sont pas fiables. L’automatisation publie plus rapidement des données erronées et leur donne une meilleure présentation : commencez par corriger les données.
Si vos rapports sont récurrents, structurés et construits à partir de données que vous pouvez interroger, le pipeline ci-dessus sera rapidement rentabilisé. Si vous souhaitez faire relire la conception par un spécialiste, envoyez à Netalith une description de votre rapport actuel pour obtenir un devis gratuit.
FAQ
Questions fréquentes
L’IA peut-elle générer directement un rapport PDF ?
Oui. Certains modèles peuvent écrire et exécuter du code dans un bac à sable pour produire un PDF, ce qui convient à un document ponctuel. Pour les rapports récurrents ou destinés à des clients, il est plus sûr de laisser le code calculer les chiffres, de demander au modèle de rédiger uniquement les commentaires sous forme de JSON structuré, puis de générer le PDF depuis un modèle fixe afin que la mise en page et les chiffres ne varient pas d’une exécution à l’autre.
Comment empêcher l’IA d’inventer des chiffres dans un rapport ?
Ne laissez jamais le modèle effectuer les calculs. Calculez chaque donnée dans le code, transmettez uniquement ces chiffres au modèle et demandez-lui de les recopier à l’identique. Effectuez ensuite un contrôle automatisé pour vérifier que chaque nombre du texte généré apparaît dans vos faits, et bloquez le rapport si ce n’est pas le cas. Un schéma JSON garantit la structure, pas l’exactitude : ce contrôle est donc indispensable.
Quelle est la meilleure bibliothèque Python pour automatiser des rapports PDF ?
Pour les rapports professionnels basés sur un modèle, WeasyPrint associé à un modèle HTML Jinja constitue une excellente solution par défaut, car la mise en page repose sur du HTML et du CSS d’impression. ReportLab convient aux mises en page denses pilotées par le code, tandis que Chromium headless convient aux pages qui nécessitent des graphiques JavaScript. Choisissez selon le modèle de mise en page, les besoins en graphiques, le poids de l’installation et la licence.
Est-il sûr d’envoyer des données professionnelles à un LLM pour rédiger un rapport ?
Commencez par réduire l’exposition : envoyez des faits agrégés plutôt que des lignes brutes concernant vos clients, puisque le modèle n’a besoin que des chiffres qu’il va décrire. Examinez ensuite les conditions de traitement des données de votre fournisseur pour votre offre. Si les données ne peuvent absolument pas quitter votre environnement, un modèle auto-hébergé est une option, avec le même pipeline autour de lui.
Puis-je automatiser des rapports lorsque mes données sources arrivent sous forme de PDF ?
Oui, mais traitez l’extraction comme une étape distincte et peu fiable. Extrayez les champs dans un format structuré, validez les totaux et les valeurs obligatoires dans le code, puis envoyez les documents présentant un faible niveau de confiance à une personne. Seules les données validées doivent alimenter les faits utilisés pour le rapport.
Comment planifier des rapports PDF automatisés ?
Regroupez le pipeline dans une seule fonction et déclenchez-la depuis le planificateur que vous utilisez déjà, comme cron, un ordonnanceur cloud ou une tâche CI planifiée. Rendez les sorties idempotentes en les identifiant par type de rapport et période, stockez les faits et le texte à côté de chaque PDF, puis alertez une personne lorsque la vérification échoue au lieu d’envoyer un rapport non contrôlé.