LLM tự triển khai cho doanh nghiệp: Kỷ nguyên AI tự chủ
Vì sao doanh nghiệp sẽ đưa dữ liệu khách hàng lên LLM tự triển khai: rủi ro CLOUD Act, quyền truy cập AI, mô hình open-weight và kiến trúc hybrid.

Long Nguyen
Lập trình viên Fullstack · Kỹ sư AI · Nhà nghiên cứu
Quan điểm của tôi trong một đoạn
Những mô hình AI mạnh nhất thế giới hiện nay được xây dựng bởi một số ít công ty Hoa Kỳ và vận hành trên hạ tầng của họ. Với một doanh nghiệp bên ngoài Hoa Kỳ, điều này tạo ra hai rủi ro không liên quan đến việc mô hình tốt đến đâu: dữ liệu bạn gửi có thể bị tiếp cận thông qua quy trình pháp lý của Hoa Kỳ, còn quyền truy cập có thể bị thay đổi hoặc đình chỉ theo chính sách của nước này. Tôi dự đoán rằng trong vài năm tới, các công ty xử lý dữ liệu khách hàng nhạy cảm sẽ chuyển phần khối lượng công việc AI đó sang những mô hình open-weight do chính họ vận hành. Frontier API sẽ không biến mất. Chúng chỉ không còn là nơi dữ liệu khách hàng được gửi đến.
Đây là một dự báo, không phải điều chắc chắn. Phần còn lại của bài viết giải thích lý do tôi đưa ra nhận định này, những điểm khiến lập luận có thể yếu hơn vẻ ngoài, và việc tự vận hành thực sự đòi hỏi những gì.
Ai kiểm soát AI mà doanh nghiệp bạn đang sử dụng?
Vào , lãnh đạo Google, OpenAI, Anthropic, Meta, xAI và Nvidia đã gặp Tổng thống Trump tại Nhà Trắng và ký một thỏa thuận tự giám sát hoạt động phát triển AI: theo dõi nội bộ, thành lập các nhóm kiểm tra hiệu quả của biện pháp bảo vệ và sử dụng kiểm toán viên bên ngoài. Thỏa thuận này mang tính tự nguyện, không ràng buộc và không đề cập đến cách xử lý dữ liệu khách hàng.
Dù bạn nghĩ gì về việc tự quản lý, hãy để ý những ai có mặt trong phòng. Các quy tắc định hình những mô hình mà phần lớn doanh nghiệp sử dụng đang được thương lượng giữa các công ty Hoa Kỳ và chính phủ Hoa Kỳ. Một phòng khám ở Đức, nhà bán lẻ ở Úc hay công ty logistics ở Việt Nam sử dụng những mô hình đó không có ghế tại bàn đàm phán. Điều khoản dịch vụ của nhà cung cấp, luật pháp và các ưu tiên của chính phủ nước họ nằm giữa bạn và chính hệ thống AI của mình.
Đây không phải thuyết âm mưu. Đó là cách quyền tài phán vận hành, cũng là lý do nhiều công ty đã lưu trữ cơ sở dữ liệu cốt lõi trên hạ tầng do họ kiểm soát.
Chính phủ Hoa Kỳ có thể truy cập dữ liệu bạn gửi đến AI API không?
Trong những điều kiện pháp lý cụ thể, câu trả lời là có, và vị trí máy chủ không làm thay đổi điều đó. CLOUD Act, được thông qua vào năm 2018, quy định rằng các nhà cung cấp Hoa Kỳ phải cung cấp dữ liệu thuộc quyền sở hữu, lưu giữ hoặc kiểm soát của họ khi nhận được yêu cầu pháp lý hợp lệ từ Hoa Kỳ, ngay cả khi dữ liệu được lưu trữ ở nước ngoài. Bộ Tư pháp Hoa Kỳ giải thích về luật này và các thỏa thuận chia sẻ dữ liệu dựa trên đó trong tài liệu về CLOUD Act. Ngoài ra, Mục 702 của FISA cho phép các cơ quan tình báo Hoa Kỳ buộc nhà cung cấp dịch vụ Hoa Kỳ hỗ trợ nhắm mục tiêu vào những người không phải công dân Hoa Kỳ đang ở bên ngoài nước này.
Dễ phóng đại vấn đề này, vì vậy dưới đây là ý nghĩa chính xác của nó:
| Nhận định | Chính xác? | Phiên bản chính xác |
|---|---|---|
| "Chọn vùng dữ liệu ở EU hoặc châu Á sẽ bảo vệ dữ liệu của tôi khỏi luật Hoa Kỳ" | Không | Nếu nhà cung cấp là công ty Hoa Kỳ, dữ liệu thuộc quyền kiểm soát của họ có thể bị tiếp cận dù đang được lưu ở đâu |
| "Chính phủ Hoa Kỳ đọc mọi thứ được gửi đến ChatGPT, Gemini hoặc Claude" | Không | Việc truy cập cần có quy trình pháp lý và nhắm đến dữ liệu cụ thể; không phải hoạt động đọc hàng loạt |
| "Cài đặt không lưu giữ dữ liệu sẽ loại bỏ rủi ro" | Một phần | Dữ liệu không được lưu sẽ không thể bị cung cấp về sau, nhưng vẫn đi qua hệ thống của nhà cung cấp |
| "Đây là vấn đề tuân thủ thực sự đối với doanh nghiệp hoạt động trong lĩnh vực chịu quản lý" | Có | Cơ quan bảo vệ dữ liệu, khách hàng doanh nghiệp và NDA ngày càng hỏi chính xác dữ liệu khách hàng được xử lý ở đâu và ai có thể buộc nhà cung cấp cho phép truy cập |
Với phần lớn doanh nghiệp vừa và nhỏ, áp lực thực tế có lẽ sẽ không đến từ yêu cầu của chính phủ. Nó sẽ đến từ bảng câu hỏi bảo mật của khách hàng, trong đó họ hỏi dữ liệu đi đâu khi AI của bạn xử lý, và câu trả lời là “một API của Hoa Kỳ” khiến bạn mất hợp đồng.
Quyền truy cập AI có thể bị tắt, không chỉ bị đọc
Vấn đề dữ liệu nhận được nhiều sự chú ý nhất, nhưng sự kiện khiến tôi thay đổi suy nghĩ trong năm nay lại liên quan đến tính sẵn sàng. Vào , Anthropic đã đình chỉ quyền truy cập vào hai mô hình chủ lực đối với toàn bộ khách hàng trên toàn thế giới sau một chỉ thị của chính phủ Hoa Kỳ viện dẫn lý do an ninh quốc gia, như được giải thích trong tuyên bố của Anthropic về việc đình chỉ quyền truy cập mô hình. Quyền truy cập được khôi phục vào , sau khi Bộ Thương mại dỡ bỏ các biện pháp kiểm soát xuất khẩu liên quan.
Ba tuần gián đoạn có thể chấp nhận được đối với một trợ lý trò chuyện. Nhưng nếu mô hình đó nằm trong quy trình xử lý đơn hàng, bộ phận hỗ trợ khách hàng hoặc một sản phẩm bạn bán thì không. Không hợp đồng nào với nhà cung cấp có thể ngăn chuyện này xảy ra, vì chính nhà cung cấp cũng không có lựa chọn.
Open weights hoạt động khác. Một khi weights của mô hình nằm trên máy chủ của bạn, chúng không thể bị thu hồi, giới hạn tốc độ, thay đổi giá hoặc tắt từ bên ngoài. Chính đặc tính này, hơn cả năng lực thông minh thuần túy, là điều tôi cho rằng doanh nghiệp sẽ bắt đầu trả tiền để có được.
Vì sao LLM tự triển khai đang phát triển mạnh lúc này
Tự triển khai không phải điều mới. Điều mới là công nghệ đã đủ tốt và đủ rẻ cho các công việc kinh doanh thông thường. Bốn yếu tố đã thay đổi:
- Chất lượng open-weight đã bắt kịp trong các tác vụ thường nhật. Trích xuất, phân loại, tóm tắt, hỗ trợ soạn trả lời khách hàng và trả lời câu hỏi trên tài liệu nội bộ không còn nhất thiết cần frontier model. Các mô hình open-weight cỡ trung xử lý tốt những việc này.
- Có nhiều dòng mô hình thực sự để lựa chọn. Qwen, DeepSeek và Kimi từ Trung Quốc, Llama của Meta, Gemma của Google, gpt-oss của OpenAI và Mistral của Pháp đều công bố weights có thể tải xuống theo các giấy phép cho phép sử dụng thương mại, nhưng bạn vẫn phải kiểm tra sự khác biệt giữa chúng.
- Phần mềm serving đã trưởng thành. Các inference server mã nguồn mở như vLLM và llama.cpp cung cấp API tương thích với OpenAI. Mã được viết cho API lưu trữ có thể trỏ đến máy chủ của bạn chỉ bằng một thay đổi cấu hình.
- Bên mua đã bắt đầu đặt câu hỏi. Điều khoản về nơi lưu trú dữ liệu, đánh giá chuyển dữ liệu theo GDPR và câu hỏi về AI trong quy trình đánh giá bảo mật nhà cung cấp hiện đã trở nên phổ biến trong bán hàng doanh nghiệp.
Chi tiết không mấy dễ chịu về open weights
Một số dòng open-weight mạnh nhất đến từ các phòng thí nghiệm Trung Quốc. Đối với chủ quyền dữ liệu, điều này ít đáng lo hơn vẻ ngoài: weights chạy trên phần cứng của bạn sẽ không gửi dữ liệu trở lại cho bên đã huấn luyện chúng. Tuy vậy, bạn vẫn cần thẩm định kỹ. Hãy đọc giấy phép, kiểm thử cách mô hình xử lý các tác vụ và chủ đề nhạy cảm của chính bạn, đồng thời chỉ tải weights từ kho chính thức của nhà phát hành. Chủ quyền có nghĩa là bạn quyết định thứ gì được chạy. Điều đó không có nghĩa là tin tưởng mù quáng vào một mô hình chỉ vì nó chạy cục bộ.
LLM tự triển khai và API: so sánh một cách trung thực
| Yếu tố | Frontier API được lưu trữ | Mô hình open-weight tự triển khai |
|---|---|---|
| Dữ liệu khách hàng đi đâu | Hạ tầng của nhà cung cấp, chịu quyền tài phán của họ | Máy chủ của bạn hoặc nhà cung cấp cục bộ do bạn lựa chọn |
| Mức độ phơi nhiễm trước quy trình pháp lý nước ngoài | Có, nếu nhà cung cấp chịu sự điều chỉnh của quy trình đó | Chỉ chịu quyền tài phán của bạn |
| Quyền kiểm soát tính sẵn sàng | Nhà cung cấp và chính phủ của họ quyết định | Bạn quyết định; weights không thể bị thu hồi |
| Giới hạn chất lượng | Cao nhất hiện có | Thấp hơn trong suy luận khó; đủ dùng cho phần lớn tác vụ thường nhật |
| Chi phí ban đầu | Không có | Phần cứng GPU hoặc máy chủ GPU thuê riêng, cộng với chi phí thiết lập |
| Chi phí khi lưu lượng cao và ổn định | Tăng tuyến tính theo số token | Phần lớn là cố định; rẻ hơn trên mỗi token khi phần cứng được khai thác hiệu quả |
| Chi phí khi lưu lượng thấp | Rẻ | Đắt; bạn vẫn phải trả tiền cho GPU không hoạt động |
| Gánh nặng vận hành | Gần như bằng không | Bạn chịu trách nhiệm cập nhật, giám sát, mở rộng và bảo mật |
| Thời gian có phiên bản đầu tiên hoạt động | Vài giờ | Vài ngày đến vài tuần |
Hãy đọc bảng trên một cách trung thực, và kết luận không phải là “tự triển khai mọi thứ”. Kết luận là: hãy tự triển khai những khối lượng công việc mà quyền kiểm soát dữ liệu hoặc tính sẵn sàng quan trọng hơn năng lực thông minh tối đa.
Thực sự cần gì để chạy LLM nội bộ?
Phần cứng: phép tính bộ nhớ
Câu hỏi đầu tiên khi định cỡ là bộ nhớ GPU. Chỉ riêng weights đã cần lượng bộ nhớ xấp xỉ số lượng tham số nhân với số byte trên mỗi tham số: 2 byte ở độ chính xác 16-bit, 1 byte ở 8-bit và khoảng nửa byte khi quantization 4-bit. Ngoài ra, KV cache tăng theo độ dài ngữ cảnh và số người dùng đồng thời, vì vậy hãy dự trù thêm 20–50% dung lượng, và nhiều hơn nếu xử lý tài liệu dài hoặc nhiều yêu cầu cùng lúc.
| Kích thước mô hình | Weights ở 16-bit | Weights ở 4-bit | Cấu hình thường phù hợp |
|---|---|---|---|
| Khoảng 8B tham số | Khoảng 16 GB | Khoảng 4 GB | Một GPU 24 GB; phù hợp cho phân loại, trích xuất và soạn thảo ngắn |
| Khoảng 32B tham số | Khoảng 64 GB | Khoảng 16 GB | Một GPU 24–48 GB ở dạng quantized; phù hợp cho RAG và trợ lý hỗ trợ khách hàng |
| Khoảng 70B tham số | Khoảng 140 GB | Khoảng 35 GB | Một GPU 48–80 GB ở dạng quantized hoặc nhiều GPU |
| Mixture-of-experts lớn (hàng trăm tỷ tham số) | Hàng trăm GB | Vẫn rất lớn | Máy chủ nhiều GPU; chỉ đáng đầu tư khi đạt quy mô thực sự |
Phần lớn trường hợp sử dụng trong doanh nghiệp mà tôi thấy nằm trong khoảng 8B đến 32B. Việc chuyển lên các mô hình open lớn nhất hiếm khi được quyết định bởi yêu cầu công việc. Thông thường, lý do lại là một ảnh chụp màn hình benchmark.
Ngăn xếp phần mềm
- Inference server cung cấp endpoint tương thích với OpenAI (vLLM cho môi trường production nhiều người dùng, llama.cpp cho thiết lập nhỏ hơn hoặc thiên về CPU).
- Truy xuất trên tài liệu của chính bạn: một embedding model cục bộ kết hợp với vector store như PostgreSQL dùng pgvector, để tài liệu cũng không rời khỏi mạng của bạn.
- Gateway cho xác thực, hạn mức theo nhóm và việc ghi log vẫn được lưu trữ nội bộ.
- Bộ dữ liệu đánh giá: các tác vụ thực tế có câu trả lời chuẩn, được chạy sau mỗi lần thay đổi mô hình hoặc prompt.
Chi phí chuyển đổi thấp hơn phần lớn đội ngũ dự đoán. Việc phục vụ một mô hình open-weight và gọi nó bằng OpenAI Python SDK tiêu chuẩn trông như sau:
# on your GPU server: serve a model downloaded from its official repository
vllm serve <model-id> --max-model-len 32768 --port 8000

# in your application: same SDK, different base_url
from openai import OpenAI

client = OpenAI(base_url="http://10.0.0.5:8000/v1", api_key="internal")

reply = client.chat.completions.create(
    model="<model-id>",
    messages=[{"role": "user", "content": "Summarize this customer ticket: ..."}],
)
print(reply.choices[0].message.content)
Thay đổi base URL là phần dễ nhất. Công việc thực sự nằm phía sau đó: kiểm tra xem mô hình nhỏ hơn có gọi công cụ một cách đáng tin cậy, tuân thủ định dạng đầu ra trong điều kiện áp lực và không bịa câu trả lời khi quá trình truy xuất không trả về kết quả hay không. Agent trên netalith.com chạy bằng API được lưu trữ, và đó là lựa chọn có chủ đích: nó trả lời dựa trên các trang công khai của chúng tôi. Một agent đọc CRM, hợp đồng hoặc hồ sơ bệnh nhân của khách hàng là một bài toán khác, và đó là lúc tôi sẽ xây dựng trên một mô hình tự triển khai. Nếu bạn đang cân nhắc chuyển dữ liệu khách hàng của mình sang mô hình như vậy, dịch vụ phát triển AI cho chatbot và data agent của chúng tôi có thể hỗ trợ từ chọn mô hình, đánh giá đến triển khai trên hạ tầng do bạn kiểm soát.
Đích đến thực tế: kiến trúc LLM hybrid
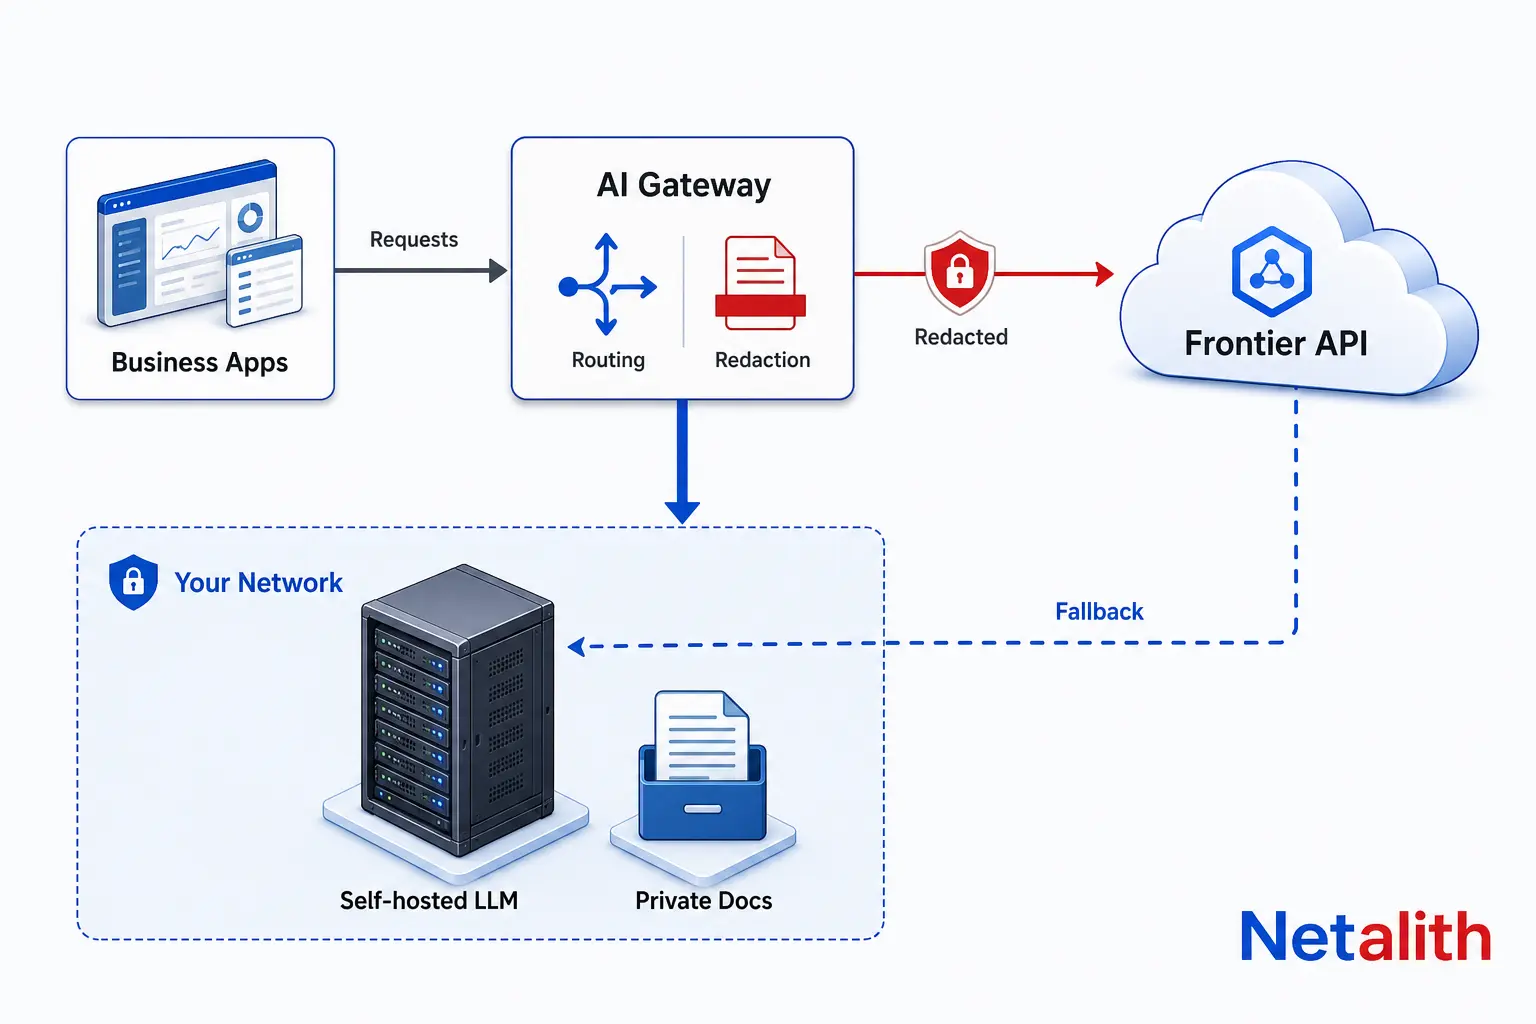
Tôi không cho rằng doanh nghiệp sẽ từ bỏ frontier API. Tôi cho rằng họ sẽ định tuyến. Dữ liệu nhạy cảm sẽ ở lại trên mô hình do doanh nghiệp vận hành. Các yêu cầu suy luận khó trên tài liệu không nhạy cảm sẽ được gửi đến API mạnh nhất hiện có. Một lớp định tuyến sẽ đưa ra quyết định và ẩn dữ liệu cá nhân trước khi bất kỳ thứ gì rời khỏi mạng.
| Khối lượng công việc | Chạy ở đâu | Lý do |
|---|---|---|
| Soạn trả lời hỗ trợ dựa trên lịch sử khách hàng | Tự triển khai | Dữ liệu cá nhân, lưu lượng cao, suy luận thường nhật |
| Hỏi đáp trên hợp đồng, hồ sơ nhân sự và hồ sơ tài chính | Tự triển khai với truy xuất cục bộ | Tài liệu bảo mật không bao giờ rời khỏi mạng |
| Phân loại và trích xuất trường dữ liệu từ đơn hàng hoặc hóa đơn | Tự triển khai, dùng mô hình nhỏ | Rẻ, nhanh và dễ đánh giá |
| Nội dung marketing, nghiên cứu công khai và mã nguồn cho dự án mã nguồn mở | Frontier API | Không có dữ liệu nhạy cảm; chất lượng tối đa đáng để chi trả |
| Phân tích khó cần dữ liệu khách hàng | Frontier API sau khi ẩn dữ liệu, hoặc mô hình lớn tự triển khai | Phụ thuộc vào mức độ nhạy cảm của dữ liệu và độ khó của tác vụ |
Thiết kế tương tự cũng giải quyết vấn đề về tính sẵn sàng. Nếu một nhà cung cấp bên ngoài biến mất trong ba tuần, lớp định tuyến sẽ chuyển sang mô hình cục bộ. Chất lượng sẽ giảm ở một số tác vụ, nhưng doanh nghiệp vẫn tiếp tục hoạt động.
Khi nào không nên tự triển khai LLM?
Thành thật về các giới hạn quan trọng hơn việc cố giành phần thắng trong tranh luận. Đừng tự triển khai nếu:
- Lưu lượng của bạn thấp. Một GPU không hoạt động trong phần lớn thời gian của ngày có thể tốn nhiều hơn chi phí gọi API trong nhiều năm.
- Không ai có khả năng vận hành. Inference server chưa được vá lỗi nhưng lại mở ra Internet là rủi ro dữ liệu lớn hơn một API uy tín có cơ chế không lưu giữ dữ liệu.
- Tác vụ thực sự cần năng lực suy luận cấp frontier và dữ liệu không nhạy cảm. Hãy trả tiền cho mô hình tốt nhất rồi tiếp tục công việc.
- Bạn không có bộ dữ liệu đánh giá. Nếu không có bộ này, bạn không thể biết mô hình cục bộ có đủ tốt hay không, và cuối cùng sẽ biết câu trả lời từ khách hàng.
Tự triển khai là một sự đánh đổi: nhiều quyền kiểm soát hơn và ít phụ thuộc hơn, đổi lại là chi phí phần cứng, vận hành và một phần chất lượng ở những tác vụ khó nhất. Lập luận của tôi là với dữ liệu khách hàng, sự đánh đổi này đang trở nên đáng giá đối với nhiều doanh nghiệp hơn đáng kể so với hai năm trước, và những công ty chuẩn bị từ bây giờ sẽ tốn ít chi phí hơn khi chuyển đổi sau này.
Nếu bạn muốn có đánh giá thẳng thắn về khối lượng công việc AI nào nên chạy nội bộ và khối lượng nào có thể tiếp tục dùng API, hãy yêu cầu báo giá miễn phí kèm mô tả ngắn về dữ liệu và lưu lượng của bạn. Bạn không mất gì khi hỏi, và câu trả lời hoàn toàn có thể là hiện tại bạn chưa cần tự triển khai.
CÂU HỎI THƯỜNG GẶP
Câu hỏi thường gặp
LLM tự triển khai là gì?
LLM tự triển khai là một mô hình ngôn ngữ open-weight chạy trên các máy chủ do bạn kiểm soát, có thể là phần cứng của riêng bạn hoặc máy chủ GPU thuê, thay vì được gọi thông qua API của nhà cung cấp. Prompt, tài liệu và đầu ra nằm trong hạ tầng của bạn.
Chính phủ Hoa Kỳ có thể truy cập dữ liệu tôi gửi đến ChatGPT, Gemini hoặc Claude không?
Theo CLOUD Act, các nhà cung cấp Hoa Kỳ phải cung cấp dữ liệu thuộc quyền sở hữu, lưu giữ hoặc kiểm soát của họ khi nhận được yêu cầu pháp lý hợp lệ từ Hoa Kỳ, ngay cả khi dữ liệu được lưu bên ngoài Hoa Kỳ. Việc này cần có quy trình pháp lý đối với dữ liệu cụ thể; không có nghĩa chính phủ đọc mọi thứ. Cài đặt không lưu giữ dữ liệu làm giảm lượng dữ liệu tồn tại để có thể bị cung cấp, nhưng dữ liệu vẫn đi qua nhà cung cấp.
LLM tự triển khai có tốt bằng GPT, Gemini hoặc Claude không?
Không phải trong những tác vụ suy luận khó nhất. Với các công việc kinh doanh thường nhật như trích xuất, phân loại, tóm tắt, hỗ trợ soạn trả lời và trả lời câu hỏi trên tài liệu nội bộ, các mô hình open-weight cỡ trung thường đủ tốt. Hãy kiểm thử trên tác vụ của chính bạn trước khi quyết định.
Tôi cần phần cứng nào để chạy LLM cho doanh nghiệp?
Điều này phụ thuộc vào kích thước mô hình. Weights cần lượng bộ nhớ xấp xỉ số tham số nhân với số byte trên mỗi tham số: mô hình 8B cần khoảng 4 GB ở 4-bit, mô hình 32B khoảng 16 GB, mô hình 70B khoảng 35 GB, cộng thêm 20–50% dung lượng dự phòng cho KV cache. Nhiều trường hợp sử dụng trong doanh nghiệp có thể chạy trên một GPU 24–48 GB.
Doanh nghiệp có thể sử dụng thương mại những mô hình open-weight nào?
Các dòng open-weight lớn gồm Qwen, DeepSeek, Kimi, Llama, Gemma, gpt-oss và Mistral. Giấy phép của chúng khác nhau, một số có điều kiện sử dụng, vì vậy hãy đọc giấy phép của đúng phiên bản mô hình trước khi triển khai.
Tôi có nên thay thế AI API bằng mô hình tự triển khai không?
Thông thường không nên thay thế hoàn toàn. Thiết lập hybrid phù hợp nhất với phần lớn doanh nghiệp: dùng mô hình tự triển khai cho mọi tác vụ liên quan đến dữ liệu khách hàng hoặc dữ liệu bảo mật, dùng frontier API cho các tác vụ không nhạy cảm cần chất lượng tối đa, đồng thời sử dụng gateway để định tuyến, ẩn dữ liệu và chuyển sang mô hình cục bộ nếu nhà cung cấp bên ngoài không còn khả dụng.