Tự động tạo báo cáo PDF bằng AI: LLM viết, code tính
Tự động hóa báo cáo PDF an toàn bằng AI: code tính số liệu, LLM viết nội dung, template dựng PDF. Có pipeline Python và bước kiểm tra.

Long Nguyen
Lập trình viên Fullstack · Kỹ sư AI · Nhà nghiên cứu
Tự động hóa báo cáo PDF bằng AI nghĩa là gì?
Để tự động hóa báo cáo PDF bằng AI, hãy chia mỗi báo cáo thành ba nhiệm vụ và giao từng nhiệm vụ cho công cụ phù hợp nhất: code tính toán số liệu, LLM viết phần diễn giải, còn template dàn trang. Những dự án gặp vấn đề thường giao cả ba việc cho model.
| Nhiệm vụ | Công cụ thực hiện | Lý do |
|---|---|---|
| Thu thập và tính toán số liệu | Code (SQL, pandas) | Kết quả xác định, có thể kiểm thử và kiểm toán |
| Viết tóm tắt và diễn giải | LLM, bị giới hạn theo JSON schema | Ngôn ngữ là phần model thực sự làm tốt |
| Dàn trang, biểu đồ và nhận diện thương hiệu | Template HTML/CSS cùng trình kết xuất | Trang có bố cục nhất quán ở mỗi lần chạy và designer có thể chỉnh sửa |
| Kiểm tra và phê duyệt | Kiểm tra tự động, sau đó có người duyệt trong những lần chạy đầu | Phát hiện những lỗi mà ba nhiệm vụ đầu tiên không thể bắt được |
Phần còn lại của hướng dẫn này xây dựng pipeline bằng Python xoay quanh một báo cáo doanh số hằng tháng. Bạn có thể thay bằng dữ liệu của mình mà vẫn giữ nguyên cấu trúc.
Vì sao không nên để LLM tạo PDF hoặc tính số liệu?
Yêu cầu model tạo PDF có thể hiệu quả trong bản demo nhưng dễ sai lệch khi đưa vào vận hành thực tế. Có ba thiết kế phổ biến, và mỗi thiết kế lại gặp vấn đề ở một điểm khác nhau.
| Thiết kế | Điểm dễ xảy ra lỗi | Nên dùng cho |
|---|---|---|
| LLM viết và chạy code tạo PDF trong sandbox | Bố cục và số liệu có thể thay đổi giữa các lần chạy, đồng thời khó kiểm toán chính xác những gì đã được tính | Tài liệu dùng một lần |
| LLM viết toàn bộ HTML, sau đó bạn chuyển thành PDF | Model kiểm soát cấu trúc và CSS nên các trang dễ lệch; markup do model tạo cũng là dữ liệu đầu vào không đáng tin cậy đối với trình kết xuất | Bản mẫu thử nghiệm |
| LLM điền JSON schema, còn bạn kiểm soát template và số liệu | Cần đầu tư nhiều công sức ban đầu hơn | Mọi báo cáo định kỳ, gửi khách hàng hoặc cần ký duyệt |
Câu hỏi quyết định là ai chịu trách nhiệm khi một con số bị sai. Nếu câu trả lời là bạn, số liệu phải đến từ code có thể kiểm thử, không phải từ một model sinh văn bản. Báo cáo định kỳ cũng cần có giao diện giống nhau vào tháng 3 và tháng 2; chỉ template mới đảm bảo được điều đó.
Pipeline: code tính toán, LLM viết, template dựng PDF
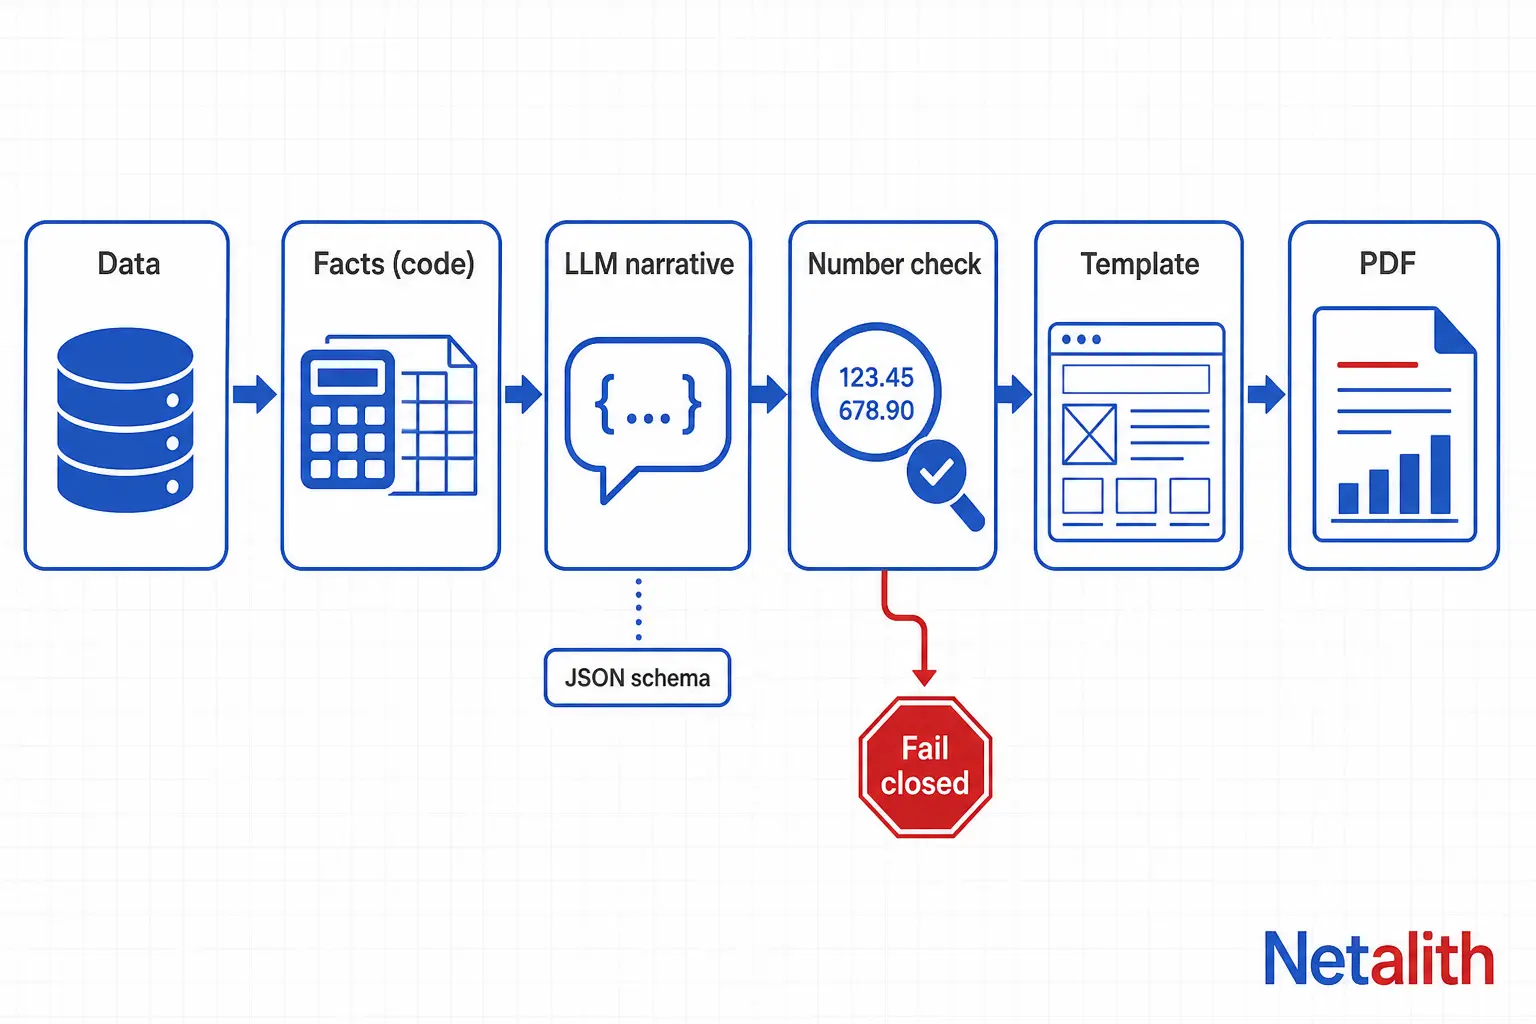
Một thiết kế bền vững gồm sáu giai đoạn. Chỉ một giai đoạn trong số đó gọi model.
- Trích xuất. Lấy dữ liệu thô từ database, CSV hoặc API.
- Tính toán sự kiện. Dùng code để tổng hợp thành một dictionary
facts. Đây là nguồn số liệu duy nhất của báo cáo. - Viết nội dung. Gửi facts cho LLM và nhận về JSON khớp với schema.
- Xác minh. Kiểm tra mọi con số trong nội dung có tồn tại trong facts hay không. Nếu không khớp thì dừng quy trình.
- Dựng PDF. Điền dữ liệu vào template HTML rồi chuyển thành PDF. Biểu đồ được code vẽ, không phải model.
- Phân phối. Lưu PDF cùng facts và nội dung, sau đó gửi đi hoặc chờ phê duyệt.
Bước 1: tính toán số liệu bằng code
Dictionary facts là hợp đồng giữa dữ liệu của bạn và mọi bước phía sau. Hãy tạo nó bằng code thông thường đã được kiểm thử và giữ cho nó nhỏ gọn: chỉ bao gồm những số liệu mà báo cáo được phép đề cập.
import pandas as pd

def build_facts(csv_path: str, month: str) -> dict:
    df = pd.read_csv(csv_path, parse_dates=["order_date"])
    period = df["order_date"].dt.to_period("M")
    cur = df[period == pd.Period(month)]
    prev = df[period == pd.Period(month) - 1]

    revenue = round(float(cur["amount"].sum()), 2)
    prev_revenue = round(float(prev["amount"].sum()), 2)
    change_pct = (
        round((revenue - prev_revenue) / prev_revenue * 100, 1)
        if prev_revenue else None      # None, never 0, when there is no baseline
    )
    top = cur.groupby("channel")["amount"].sum().nlargest(3)

    return {
        "month": month,
        "orders": int(len(cur)),
        "revenue": revenue,
        "prev_revenue": prev_revenue,
        "revenue_change_pct": change_pct,
        "top_channels": [
            {"name": name, "revenue": round(float(v), 2)} for name, v in top.items()
        ],
    }
Có hai thói quen rất quan trọng. Hãy trả về None khi không thể tính một giá trị, vì số 0 trông giống một kết quả thực và model sẽ sẵn sàng diễn giải nó. Đồng thời, chỉ làm tròn một lần trong hàm này để nội dung và bảng trong PDF không bao giờ lệch nhau.
Bước 2: giới hạn nội dung bằng JSON schema
Hãy yêu cầu model trả về các trường dữ liệu, không phải một tài liệu hoàn chỉnh. Mỗi trường là một vị trí để template đặt vào, vì vậy model không thể tự ý di chuyển, thêm hoặc đổi kiểu bất kỳ thành phần nào trên trang. Schema-constrained output là công cụ phù hợp: theo tài liệu Structured Outputs của OpenAI, nó buộc câu trả lời tuân theo JSON Schema thay vì chỉ cần là JSON hợp lệ, đồng thời việc model từ chối trả lời có thể được phát hiện bằng code. Nếu dùng nhà cung cấp khác, hãy tìm chế độ output bị giới hạn theo schema; nguyên tắc vẫn giống nhau.
import json
from openai import OpenAI
from pydantic import BaseModel

client = OpenAI()
MODEL = "your-validated-model"   # pin the model you tested; re-test before changing it

class ReportNarrative(BaseModel):
    headline: str
    summary: str
    channel_notes: list[str]
    risks: list[str]

SYSTEM = (
    "You write the commentary for a monthly sales report. "
    "Use ONLY numbers that appear in the facts JSON, copied exactly. "
    "Never calculate, round or estimate. If a value is null, say it is unavailable. "
    "Do not claim trends, causes or records that the facts do not show."
)

def write_narrative(facts: dict) -> ReportNarrative:
    response = client.responses.parse(
        model=MODEL,
        input=[
            {"role": "system", "content": SYSTEM},
            {"role": "user", "content": json.dumps(facts)},
        ],
        text_format=ReportNarrative,
    )
    if response.output_parsed is None:   # refusal or incomplete output
        raise RuntimeError("No valid narrative returned")
    return response.output_parsed
Hãy nhớ schema không làm được điều gì. Nó đảm bảo cấu trúc chứ không đảm bảo tính đúng đắn: một chuỗi hoàn toàn hợp lệ vẫn có thể chứa con số do model bịa ra. Đó là lý do cần bước tiếp theo. Ngoài ra, hãy gửi facts đã tổng hợp thay vì các dòng dữ liệu khách hàng thô. Model chỉ cần những số liệu nó sẽ diễn giải, và gửi ít dữ liệu hơn là biện pháp kiểm soát quyền riêng tư tiết kiệm nhất.
Bước 3: kiểm tra mọi con số trước khi phát hành PDF
Đây là giai đoạn mà phần lớn hướng dẫn bỏ qua, nhưng nó giúp pipeline an toàn khi chạy không cần giám sát. Hãy trích xuất mọi con số từ nội dung được tạo và yêu cầu từng số phải xuất hiện trong facts. Nếu có số không khớp, hãy báo lỗi và không phát hành tài liệu.
import re

NUM = re.compile(r"\d[\d,]*\.?\d*")

def to_float(token: str) -> float:
    return float(token.replace(",", "").rstrip("."))

def fact_numbers(obj) -> set[float]:
    nums: set[float] = set()
    if isinstance(obj, dict):
        for v in obj.values():
            nums |= fact_numbers(v)
    elif isinstance(obj, list):
        for v in obj:
            nums |= fact_numbers(v)
    elif isinstance(obj, str):
        nums |= {to_float(m) for m in NUM.findall(obj)}   # catches "2026-09" style periods
    elif isinstance(obj, (int, float)) and not isinstance(obj, bool):
        nums.add(float(obj))
    return nums

def check_narrative(facts: dict, n) -> None:
    allowed = fact_numbers(facts)
    text = " ".join([n.headline, n.summary, *n.channel_notes, *n.risks])
    unknown = [m for m in NUM.findall(text)
               if not any(abs(to_float(m) - a) < 0.01 for a in allowed)]
    if unknown:
        raise ValueError(f"Numbers not found in facts: {unknown}")
Khi đã có bước kiểm tra, toàn bộ quy trình chỉ còn bốn dòng:
facts = build_facts("orders.csv", "2026-09")
narrative = write_narrative(facts)
check_narrative(facts, narrative)          # raises, so nothing ships
render_pdf(facts, narrative, "reports/sales-2026-09.pdf")
Bước kiểm tra này cố tình nghiêm ngặt. Model viết 12 phần trăm trong khi số liệu thực là 12,4 sẽ bị từ chối; một số dư thừa như số 3 trong “3 kênh đứng đầu” cũng vậy, trừ khi bạn cho phép các số thứ tự nhỏ. Hãy điều chỉnh prompt trước khi nới lỏng bước kiểm tra. Số liệu chỉ là một nửa vấn đề: thêm vào prompt yêu cầu không nêu nguyên nhân, xu hướng hay kỷ lục mà facts không thể hiện, đồng thời tự đọc những nội dung đầu tiên.
Trong những tuần đầu của bất kỳ báo cáo mới nào, hãy giữ PDF để người kiểm tra phê duyệt và chỉ chuyển sang gửi tự động sau khi bước kiểm tra đã chạy ổn định một thời gian. Lưu lại các nội dung bị từ chối; chúng cho biết chỉ dẫn nào trong prompt đang bị bỏ qua.
Bước 4: dựng PDF từ template
Viết báo cáo dưới dạng template HTML thông thường rồi để trình kết xuất chuyển nó thành PDF. WeasyPrint là lựa chọn mặc định tốt cho tài liệu doanh nghiệp vì hỗ trợ print CSS. Tài liệu chính thức của phiên bản 70.0 liệt kê Python 3.10 trở lên và Pango 1.44 trở lên là các yêu cầu, đồng thời khuyến nghị cài đặt bằng pip rồi chạy weasyprint --info để xác nhận các thư viện hệ thống đã được tìm thấy.
Template nắm quyền kiểm soát bố cục, còn các trường nội dung được đưa vào đó:
<h1>{{ n.headline }}</h1>
<p class="lead">{{ n.summary }}</p>
<table>
  {% for c in facts.top_channels %}
  <tr><td>{{ c.name }}</td><td>{{ "{:,.2f}".format(c.revenue) }}</td></tr>
  {% endfor %}
</table>
Kích thước trang, lề và số trang chỉ cần dùng CSS thông thường:
@page {
  size: A4;
  margin: 18mm;
  @bottom-center { content: "Page " counter(page) " of " counter(pages); }
}
Sau đó tiến hành kết xuất. Jinja đã bật autoescaping, vì vậy nội dung từ model được chèn dưới dạng dữ liệu và không bao giờ được diễn giải như markup:
from pathlib import Path
from urllib.parse import unquote, urlparse

from jinja2 import Environment, FileSystemLoader, select_autoescape
from weasyprint import HTML
from weasyprint.urls import URLFetcher

TEMPLATES = Path("templates").resolve()
env = Environment(loader=FileSystemLoader(TEMPLATES), autoescape=select_autoescape(["html"]))

class AssetsOnlyFetcher(URLFetcher):
    # Local files are allowed only inside the templates folder
    def fetch(self, url, headers=None):
        if url.startswith("file:"):
            path = Path(unquote(urlparse(url).path)).resolve()
            if not path.is_relative_to(TEMPLATES):
                raise ValueError(f"Blocked local file: {url}")
        return super().fetch(url, headers)

def render_pdf(facts: dict, narrative, out_path: str) -> None:
    page = env.get_template("monthly_report.html").render(facts=facts, n=narrative)
    HTML(string=page, base_url=str(TEMPLATES), url_fetcher=AssetsOnlyFetcher()).write_pdf(out_path)
Có ba chi tiết trong tài liệu đáng được tính đến khi thiết kế:
- Font. Nếu thiếu font, PDF có thể hiển thị ô vuông hoặc không hiển thị chữ thay vì ký tự. Lỗi này thường xuất hiện trước tiên với văn bản có dấu hoặc không dùng bảng chữ cái Latin. Hãy cài font trên server hoặc tham chiếu chúng bằng
@font-face; nếu tải CSS qua CSS object, hãy truyềnFontConfigurationnhư tài liệu hướng dẫn. - Bảo mật. Tài liệu cảnh báo HTML hoặc CSS không đáng tin cậy có thể đọc các file cục bộ và nhúng chúng vào output. Hãy xem output từ model là dữ liệu không đáng tin cậy: không cho model xuất raw HTML, luôn bật autoescape và giới hạn quyền truy cập file như fetcher ở trên. WeasyPrint bắt lỗi từ fetcher và chuyển chúng thành cảnh báo, vì vậy file bị chặn sẽ được bỏ qua thay vì làm hỏng lần chạy. Class-based fetcher ở đây là cách được tài liệu 70.0 mô tả; các bản cũ hơn dùng một function thông thường.
- Tốc độ. Tài liệu lưu ý việc kết xuất có thể chậm với tài liệu dài và đề xuất dùng process chạy lâu dài khi xử lý nhiều tài liệu để chỉ phải trả chi phí khởi động một lần. Một worker luôn hoạt động sẽ hiệu quả hơn việc khởi chạy process mới cho từng PDF.
Hãy dùng matplotlib hoặc SVG để vẽ biểu đồ bằng code rồi nhúng chúng dưới dạng hình ảnh. Model có thể diễn giải biểu đồ nhưng không được tự vẽ biểu đồ.
Nên dùng thư viện Python nào để dựng PDF?
Hãy chọn trình kết xuất dựa trên ba tiêu chí: cách bạn muốn mô tả bố cục, việc có cần biểu đồ JavaScript hay không, và những gì bạn chấp nhận cài đặt cũng như cấp phép cho công việc với khách hàng. Trước khi phát hành cho khách hàng, hãy xác nhận license hiện hành của đúng phiên bản bạn sử dụng.
| Lựa chọn | Mô hình bố cục | Biểu đồ | Mức độ cài đặt | License | Nên chọn khi |
|---|---|---|---|---|---|
| WeasyPrint | HTML và print CSS | Hình ảnh tĩnh hoặc SVG; không có JavaScript | Python cùng các thư viện hệ thống Pango | BSD-3-Clause | Báo cáo doanh nghiệp theo template mà designer có thể chỉnh sửa |
| ReportLab | Code Python | Công cụ vẽ và biểu đồ tích hợp | Nhẹ, phần lớn cài qua pip | Phiên bản mã nguồn mở, kiểu BSD; có add-on thương mại | Bố cục dày đặc, điều khiển bằng code và xử lý số lượng lớn |
| Headless Chromium qua Playwright | Trình duyệt đầy đủ | Biểu đồ JavaScript như Chart.js | Nặng: cần tải trình duyệt | Apache-2.0 cho Playwright | PDF phải khớp chính xác với một dashboard web hiện có |
Với phần lớn báo cáo doanh nghiệp định kỳ, WeasyPrint kết hợp template Jinja là con đường ngắn nhất để xây dựng pipeline dễ bảo trì. Chỉ chuyển sang Chromium khi bạn thực sự cần JavaScript để vẽ trang.
Cách lên lịch và phân phối báo cáo PDF tự động
Sau khi một lần chạy hoạt động ổn định, phần việc còn lại thuộc về vận hành. Đây là những quyết định giúp báo cáo theo lịch luôn đáng tin cậy:
- Kích hoạt. Dùng bất kỳ scheduler nào bạn đang vận hành: cron trên server, cloud scheduler, scheduled CI workflow hoặc task queue. Pipeline chỉ là một hàm Python thông thường nên không phụ thuộc vào công cụ nào.
- Idempotency. Định danh mỗi output theo loại báo cáo và kỳ báo cáo để lần chạy lại thay thế file cũ thay vì tạo bản trùng lặp.
- Audit trail. Lưu facts, nội dung, phiên bản template và PDF cuối cùng cùng nhau. Khi có người thắc mắc về một con số, bạn có thể chỉ ra chính xác nguồn gốc của nó.
- Cách xử lý lỗi. Nếu bước xác minh thất bại, hãy cảnh báo cho một người và giữ lại PDF tốt gần nhất. Không bao giờ gửi báo cáo chưa được kiểm tra.
- Phân phối. Gửi liên kết qua email với file lớn, gửi file đính kèm với file nhỏ và ghi lại người đã nhận phiên bản nào.
Lời gọi model chỉ là một request cho mỗi báo cáo, vì vậy chi phí vận hành lớn hơn thường nằm ở thời gian con người kiểm tra, không phải phí API. Hãy tối ưu bước phê duyệt thay vì kéo dài prompt. Nếu muốn xây dựng giải pháp dựa trên nguồn dữ liệu và template riêng, Netalith phát triển AI report agent tạo file PDF, DOCX, Excel và PowerPoint.
Khi nào không nên tự động hóa báo cáo PDF?
Tự động hóa có chi phí cố định: template, code tạo facts, các bước kiểm tra và hệ thống giám sát. Trong những trường hợp sau, khoản đầu tư này không đáng:
- Báo cáo chỉ được tạo vài lần mỗi năm. Thời gian xây dựng template còn lâu hơn số giờ tiết kiệm được.
- Mỗi người nhận cần một cấu trúc khác nhau và không có khung chung để đưa vào template.
- Giá trị của báo cáo nằm ở phán đoán chuyên môn, chẳng hạn ý kiến pháp lý hoặc kết luận kiểm toán. AI có thể soạn phần xung quanh, nhưng phần bạn thực sự bán lại không phải phần đang được tự động hóa.
- Dữ liệu nguồn không đáng tin cậy. Tự động hóa sẽ xuất bản dữ liệu sai nhanh hơn và trình bày đẹp hơn, vì vậy hãy xử lý dữ liệu trước.
Nếu báo cáo của bạn có tính định kỳ, cấu trúc rõ ràng và được xây dựng từ dữ liệu có thể truy vấn, pipeline trên sẽ nhanh chóng mang lại hiệu quả. Nếu muốn có thêm người cùng xem xét thiết kế, hãy gửi Netalith mô tả về báo cáo hiện tại để nhận báo giá miễn phí.
CÂU HỎI THƯỜNG GẶP
Câu hỏi thường gặp
AI có thể tạo trực tiếp một báo cáo PDF không?
Có. Một số model có thể viết và chạy code trong sandbox để tạo PDF, phù hợp với tài liệu dùng một lần. Với báo cáo định kỳ hoặc gửi khách hàng, cách an toàn hơn là để code tính số liệu, model chỉ viết phần diễn giải dưới dạng JSON có cấu trúc, rồi dựng PDF từ template cố định để bố cục và số liệu không bị thay đổi giữa các lần chạy.
Làm sao để ngăn AI bịa số liệu trong báo cáo?
Không bao giờ để model tự tính. Hãy tính mọi số liệu bằng code, chỉ cung cấp cho model những số liệu đó và yêu cầu sao chép chính xác. Sau đó chạy bước kiểm tra tự động để xác nhận mọi con số trong nội dung được tạo đều xuất hiện trong facts; nếu có số không khớp, hãy chặn báo cáo. JSON schema chỉ đảm bảo cấu trúc, không đảm bảo độ chính xác, nên bước kiểm tra là bắt buộc.
Thư viện Python nào tốt nhất để tự động tạo báo cáo PDF?
Với báo cáo doanh nghiệp theo template, WeasyPrint kết hợp template HTML của Jinja là lựa chọn mặc định tốt vì bố cục dùng HTML và print CSS thông thường. ReportLab phù hợp với bố cục dày đặc, điều khiển bằng code; còn headless Chromium phù hợp với các trang cần biểu đồ JavaScript. Hãy lựa chọn dựa trên mô hình bố cục, nhu cầu về biểu đồ, mức độ cài đặt và license.
Gửi dữ liệu doanh nghiệp cho LLM viết báo cáo có an toàn không?
Trước tiên hãy giảm mức độ dữ liệu bị phơi lộ: gửi facts đã tổng hợp thay vì các dòng dữ liệu khách hàng thô, vì model chỉ cần những số liệu nó sẽ diễn giải. Sau đó xem xét điều khoản xử lý dữ liệu của nhà cung cấp và gói dịch vụ bạn dùng. Nếu dữ liệu tuyệt đối không được rời khỏi môi trường của bạn, có thể dùng model self-hosted với cùng pipeline bao quanh.
Có thể tự động hóa báo cáo khi dữ liệu nguồn đến dưới dạng PDF không?
Có, nhưng hãy xem bước trích xuất là một công đoạn riêng và không đáng tin cậy. Đưa các trường dữ liệu vào cấu trúc rõ ràng, kiểm tra tổng và các giá trị bắt buộc bằng code, rồi chuyển những tài liệu có độ tin cậy thấp cho người xử lý. Chỉ dữ liệu đã được xác minh mới được đưa vào facts dùng cho báo cáo.
Làm sao lên lịch tạo báo cáo PDF tự động?
Gói pipeline trong một hàm duy nhất và kích hoạt nó từ scheduler bạn đang dùng, chẳng hạn cron, cloud scheduler hoặc scheduled CI job. Đảm bảo output có tính idempotent bằng cách định danh theo loại báo cáo và kỳ báo cáo; lưu facts và nội dung cạnh từng PDF; đồng thời cảnh báo cho người phụ trách khi bước xác minh thất bại thay vì gửi một báo cáo chưa được kiểm tra.